10. 调用接口
完整版章节。内容按 2026.10 主线代码与运行环境界面核对;具体入口以当前许可、账号权限和交付环境为准。
本章内容:本章面向接入网关的开发人员和技术负责人,说明业务应用怎样通过网关调用模型——三种协议的路径与鉴权、流式输出、嵌入重排图像语音、批量判断、协议入口与端口、官方 SDK 与编程客户端、幂等键、参数自动适配,以及请求体与 Token 上限和统一错误格式。
网关在入口完成鉴权、授权、额度与流量规则判断,再把请求转换为上游供应商的格式;响应与错误按调用方使用的协议原样返回,因此已按某家协议写好的代码只需改 Base URL 与密钥。凭据的申请与状态管理见第 8、9 章;流量规则与防护的配置见第 15 章。
10.1 入口地址与鉴权
适用场景:第一次接入,或要从已有代码切换到网关。
前提:已持有一把 API 密钥(见 8.4 节),且要调用的模型属于这把密钥绑定的模型分组。
Base URL 由网关访问地址加固定前缀组成,可在模型详情「首次调用 API」中直接复制。下文 <网关地址> 指该访问地址:
| 协议 | Base URL | 鉴权请求头 |
|---|---|---|
| :-- | :-- | :-- |
| OpenAI 兼容 | https://<网关地址>/api/v1/agent-gateway/openai/v1 | Authorization: Bearer <YOUR_API_KEY> |
| Anthropic | https://<网关地址>/api/v1/agent-gateway/anthropic | x-api-key: <YOUR_API_KEY>,也接受 Authorization: Bearer |
| Gemini | https://<网关地址>/api/v1/agent-gateway/gemini | x-goog-api-key: <YOUR_API_KEY> 或查询参数 ?key=,也接受 Authorization: Bearer |
注意
- 各协议只认自己的原生请求头。OpenAI 路径不接受
x-api-key,请使用Authorization: Bearer;同一请求不要同时携带两种取值不同的凭据。 - 所有模型调用都必须携带凭据,不能按路由关闭认证。
- 模型名(OpenAI、Anthropic 为请求体的
model字段,Gemini 为路径中的模型名)填模型详情中复制的调用名;不在本密钥绑定的模型分组中时返回 404LLM_MODEL_NOT_AVAILABLE。
结果确认:调用成功时响应头带 x-request-id,在「运行总览 › 请求」中按该值可查到这次调用,发起人与接入凭据和密钥持有人一致(见 9.9 节)。
10.2 OpenAI 兼容接口
官方 OpenAI SDK 只需修改 base_url 和 api_key。路径相对于 OpenAI Base URL:
| 方法与路径 | 用途 | 流式 |
|---|---|---|
| :-- | :-- | :-- |
POST /chat/completions | 对话,支持工具调用 | 支持 |
POST /responses | OpenAI Responses | 支持 |
POST /completions | 旧式文本补全(需上游模型支持) | 不支持 |
GET /models、GET /models/{model} | 列出或查询模型 | 不适用 |
curl https://<网关地址>/api/v1/agent-gateway/openai/v1/chat/completions \
  -H "Authorization: Bearer <YOUR_API_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "<模型名>",
    "messages": [{"role": "user", "content": "用一句话介绍杭州。"}],
    "max_tokens": 200
  }'
from openai import OpenAI
client = OpenAI(
base_url="https://<网关地址>/api/v1/agent-gateway/openai/v1",
api_key="<YOUR_API_KEY>",
)
resp = client.chat.completions.create(
model="<模型名>",
messages=[{"role": "user", "content": "用一句话介绍杭州。"}],
max_tokens=200,
)
print(resp.choices[0].message.content)查可用模型用 client.models.list(),返回每个模型的 id。
你会看到
chat/completions返回标准chat.completion结构(choices、message、usage);思考型模型额外带reasoning_content。responses返回标准response对象,status为completed,output中同时包含消息段与推理段,output_text为最终答复。completions只有上游模型支持时可用;不支持时在网关侧直接返回 400,reason为MODEL_ENDPOINT_UNSUPPORTED(「This model service does not support the requested endpoint or call style.」),请求不会派发到上游,也不产生费用。GET /models返回的是平台模型目录中的模型,其中可能包含这把密钥所属服务内未启用的模型;用它们发起调用会返回 404LLM_MODEL_NOT_AVAILABLE。
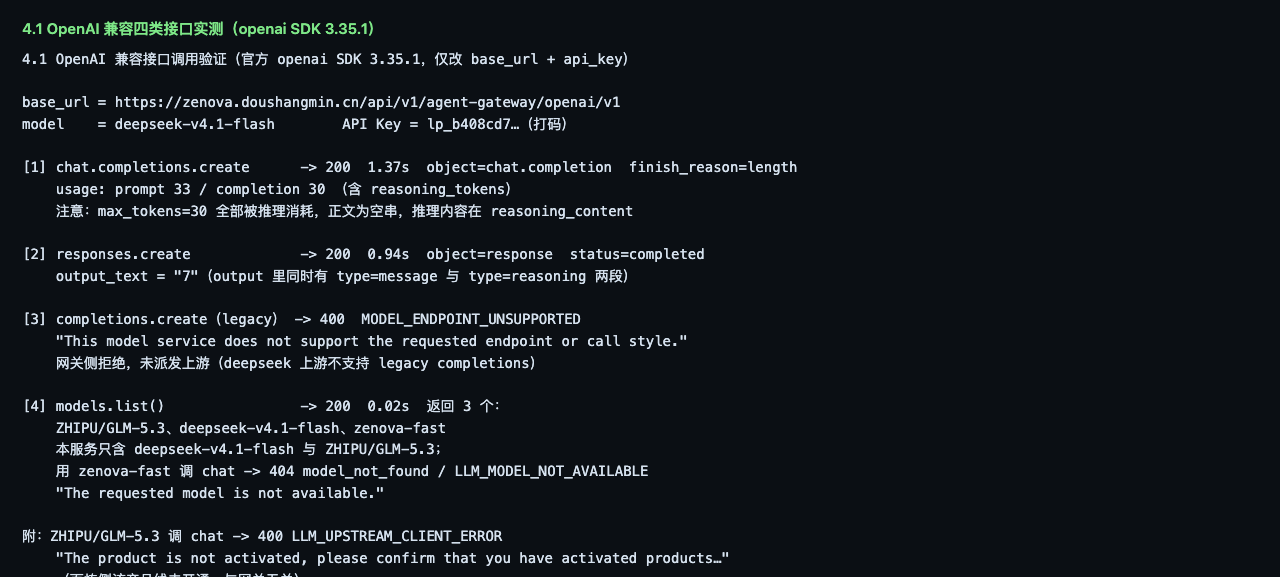
注意:思考型模型在 max_tokens 很小时,推理可能把额度全部用掉,content 为空串、finish_reason 为 length,这是模型正常表现而非网关截断,放大 max_tokens 即可。上游侧错误(如产品线未开通)以 400 LLM_UPSTREAM_CLIENT_ERROR 返回并带上游原文,需到供应商控制台处理。
10.3 Anthropic 与 Gemini 原生接口
已按 Anthropic 或 Google 官方 SDK 开发的业务,只改 Base URL 即可,不必改写请求格式。
Anthropic:POST /v1/messages(支持流式,接受 anthropic-version 与 anthropic-beta 请求头)、GET /v1/models、GET /v1/models/{model}。
import anthropic

client = anthropic.Anthropic(
    base_url="https://<网关地址>/api/v1/agent-gateway/anthropic",
    api_key="<YOUR_API_KEY>",
)
msg = client.messages.create(
    model="<模型名>",
    max_tokens=1024,
    messages=[{"role": "user", "content": "你好"}],
)Gemini:POST /v1beta/models/{model}:generateContent、POST /v1beta/models/{model}:streamGenerateContent,同时接受 /v1/models/... 路径;GET /v1beta/models、GET /v1beta/models/{model}。
from google import genai

client = genai.Client(
    api_key="<YOUR_API_KEY>",
    http_options={
        "base_url": "https://<网关地址>/api/v1/agent-gateway/gemini",
        "api_version": "v1beta",
    },
)
resp = client.models.generate_content(model="<模型名>", contents="你好")
你会看到
- Anthropic 返回
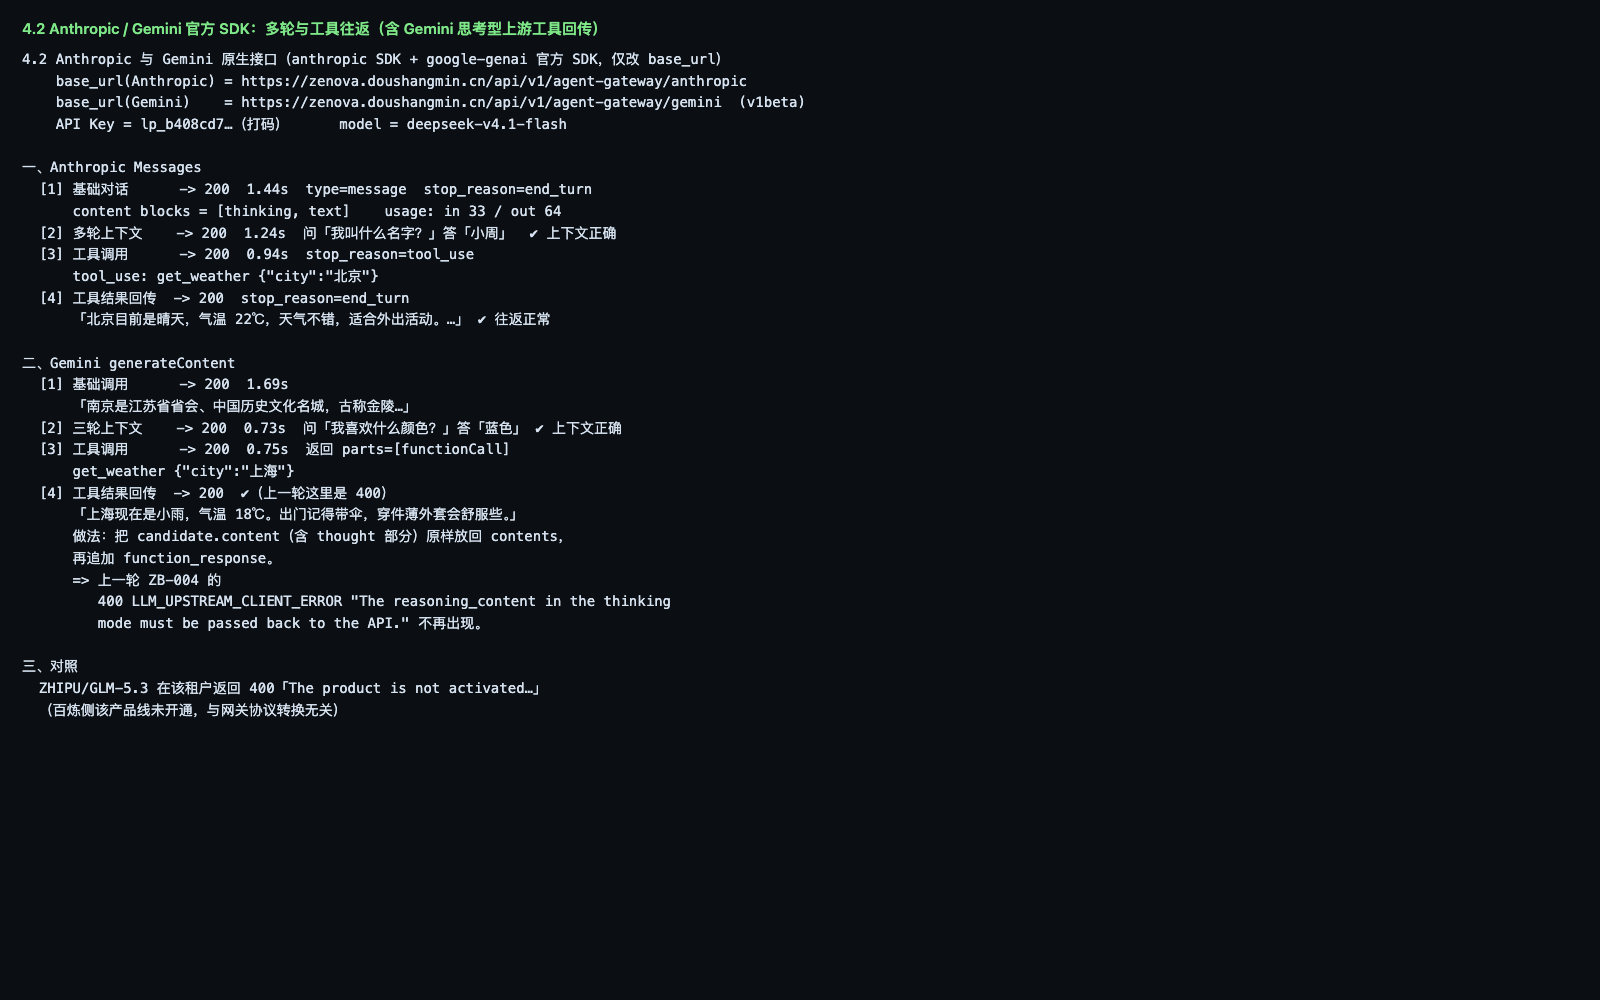
type: message,stop_reason为end_turn;思考型模型的内容块为[thinking, text];工具调用时stop_reason为tool_use,内容块中给出工具名与参数。 - Gemini 返回
candidates,文本在candidates[0].content.parts中;工具调用以function_call返回,参数为结构化对象。 - 多轮对话与工具往返在两种原生协议上都能闭环:Anthropic 的
tool_use→ 回传tool_result、Gemini 的functionCall→ 回传functionResponse,都能拿到最终答复。 - 调用记录里「客户端请求」保留你发出的原生结构,「发往上游的请求」是上游实际使用的格式,可据此核对网关做的转换。
注意
- Gemini 工具往返时,把上一轮返回的
candidate.content整块原样放回contents,再追加function_response。思考型上游需要把思考内容带回去,网关负责还原;自行裁剪会丢失上下文。 - 原生协议与 OpenAI 兼容协议走同一条接入管线,鉴权、额度池、流量规则与计量完全一致,不必为不同协议单独配置。
10.4 流式输出
适用场景:需要逐字显示的聊天界面,或需要在生成过程中尽早把内容交给下游处理的场景。
开启方式:OpenAI 与 Anthropic 在请求体中设置 "stream": true;OpenAI 可再加 "stream_options": {"include_usage": true},在结尾获得用量;Gemini 使用 :streamGenerateContent 方法。
curl https://<网关地址>/api/v1/agent-gateway/openai/v1/chat/completions \
  -H "Authorization: Bearer <YOUR_API_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "<模型名>",
    "messages": [{"role": "user", "content": "写一段三百字的产品介绍。"}],
    "stream": true,
    "stream_options": {"include_usage": true}
  }'
你会看到
- 响应头为
content-type: text/event-stream; charset=utf-8、transfer-encoding: chunked、cache-control: no-cache。 - 每个数据帧是一段增量内容;思考型模型的推理增量在
reasoning_content中,正文增量在content中。 - OpenAI 协议以带
finish_reason与usage的最后一帧加上data: [DONE]结束;Anthropic 协议以message_delta与message_stop结束;Gemini 以流结束。
注意
- 网关只在上游返回首个内容之前重试或切换目标;内容一旦开始输出就不再重试,避免重复内容。参数类错误(400)不重试、不切换,
x-should-retry为false。 - 客户端读到一半主动断开时不会收到
[DONE],这是客户端放弃请求,不代表上游截断。 - 中间代理或负载均衡的空闲超时不要设得比生成间隔还短,否则长回答会在中途被切掉。
- 上游未发出结束信号就断开时,网关按截断处理:补发一条同形的流内错误帧,并在调用记录里标记为失败,不会当作正常完成返回。
10.5 嵌入、重排、图像与语音
适用场景:知识库检索需要向量化、搜索需要重排、应用需要生图或语音合成、需要把录音转成文字。
前提:这些能力只提供 OpenAI 兼容格式,路径相对于 OpenAI Base URL;调用前,目标模型的上游必须声明对应用途(向量、重排、生图、语音合成、语音转写)。上游不支持该接口时网关在派发前直接返回 400 MODEL_ENDPOINT_UNSUPPORTED;模型不属于这把密钥绑定的分组时返回 404 LLM_MODEL_NOT_AVAILABLE。
| 方法与路径 | 关键参数 | 计费依据 |
|---|---|---|
| :-- | :-- | :-- |
POST /embeddings | model、input(字符串或字符串数组) | 输入 Token |
POST /rerank | model、query、documents | 检索次数与文档数 |
POST /images/generations、/images/edits | model、prompt、n、size | 返回的图片张数 |
POST /audio/speech | model、input、voice | 输入字符数 |
POST /audio/transcriptions | multipart 表单,字段 model、file | 音频时长 |
{ "model": "<向量模型名>", "input": ["退款进度怎么查", "订单已发货", "发票如何开具"] }{ "model": "<重排模型名>", "query": "退款进度", "documents": ["订单已发货。", "退款将在三个工作日内到账。"] }你会看到:向量接口返回 data 数组,每项含 embedding 与 index;重排接口返回按相关度排序的结果;生图接口返回图片地址或 base64;语音合成返回音频二进制,语音转写返回文本。模型未声明对应能力时,语音类端点都在网关侧被拦下(400),请求不会到达上游。
注意
- 重排接口只在 OpenAI Base URL 下提供(
/openai/v1/rerank),其他协议路径没有对应端点。 - 语音转写只读取音频文件头计算时长,不解码整段音频;无法识别格式时返回 400,文件超过 25 MiB 时返回 413。
- 上游供应商暂时不可用时返回 503
LLM_PROVIDER_UNAVAILABLE,带Retry-After,按该值重试即可。 - 服务里只有对话模型时,这些调用会以 400 或 404 被拒,属正常配置结果而非接口故障。
10.6 批量判断
适用场景:对一段内容一次回答多道是非、选择或评分题,例如工单分类、意图识别、内容合规预判,一次请求替代多次单独调用。
前提:模型的上游声明了「判断」用途。
请求格式:POST /decisions,请求体包含 model、input(被判断的内容)和 questions。每道题包含 name(题名)、instructions(题目说明)和 type:
| type | 含义 | 附加字段 | 答案 |
|---|---|---|---|
| :-- | :-- | :-- | :-- |
predicate | 是非题 | 无 | 概率 |
choice | 选择题 | choices:至少 2 项,每项含 value、description | 所选的 value |
score | 评分题 | levels:至少 1 级,每级含 label、description | 所选等级 |
{
  "model": "<判断模型名>",
  "input": "这笔订单被扣了两次款,我要求马上退款!",
  "questions": [
    { "name": "is_complaint", "instructions": "这是不是一条投诉?", "type": "predicate" },
    { "name": "department", "instructions": "应该交给哪个部门?", "type": "choice",
      "choices": [ { "value": "billing", "description": "付款、发票和退款。" },
                   { "value": "other", "description": "以上都不是。" } ] }
  ]
}
POST /systemone 是同一用途的另一种格式:用 state 放被判断的内容,questions 为按题名索引的对象。网关把两种格式统一转换为上游需要的格式后发送。
你会看到:返回 200,按题名给出每道题的答案,与提交顺序无关;调用记录中这次调用的用途显示为「判断」。
注意
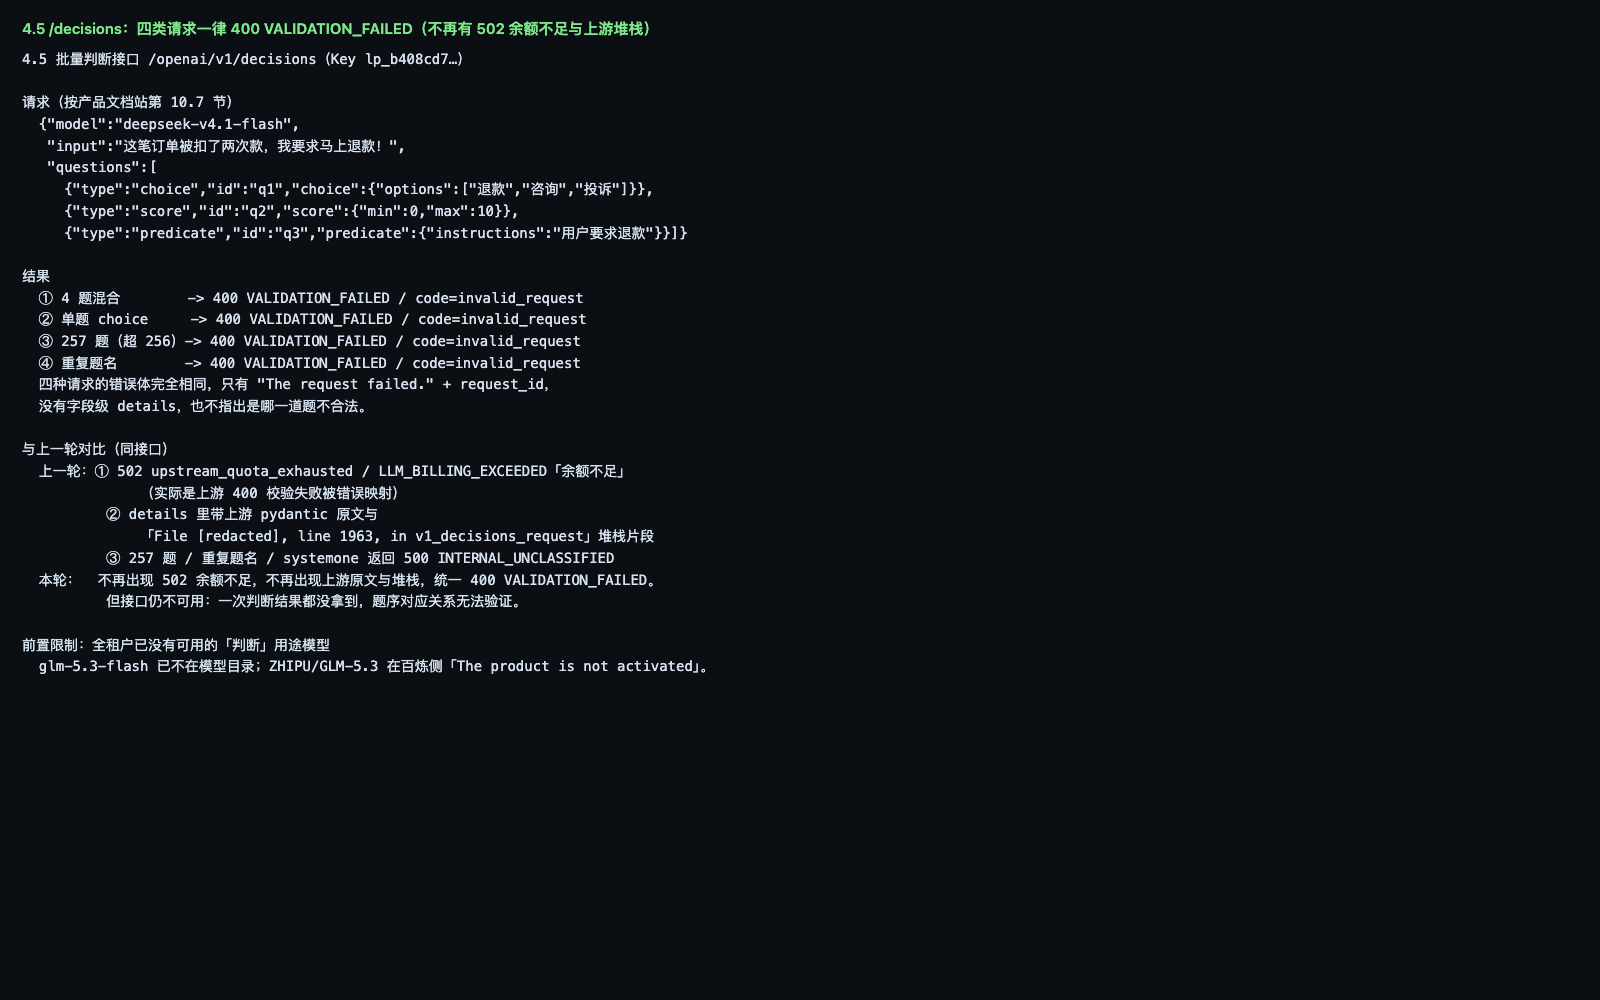
- 一次请求最多 256 题,题名不能重复。请求结构不合法时返回 400
VALIDATION_FAILED,错误体中带request_id,请附上该值联系管理员定位。 - 所选模型不支持判断时返回 400
MODEL_ENDPOINT_UNSUPPORTED;图片只能以data:地址放入内容。 - 不同上游给出的判断分数不能直接比较,横向比较时先统一到一个上游;计费同时计入输入与输出 Token。
10.7 协议入口、端口与传输
一个入口,多种协议:模型网关只对外提供一个入口地址,三种协议通过不同的路径前缀区分:
| 路径前缀 | 协议 |
|---|---|
| :-- | :-- |
/api/v1/agent-gateway/openai/v1 | OpenAI 兼容(含嵌入、重排、图像、语音) |
/api/v1/agent-gateway/anthropic | Anthropic |
/api/v1/agent-gateway/gemini | Gemini |
网关按前缀识别入站协议,再按目标模型的格式转发。同一个模型、同一把密钥可以同时被三种协议调用,计量与限额合并统计。
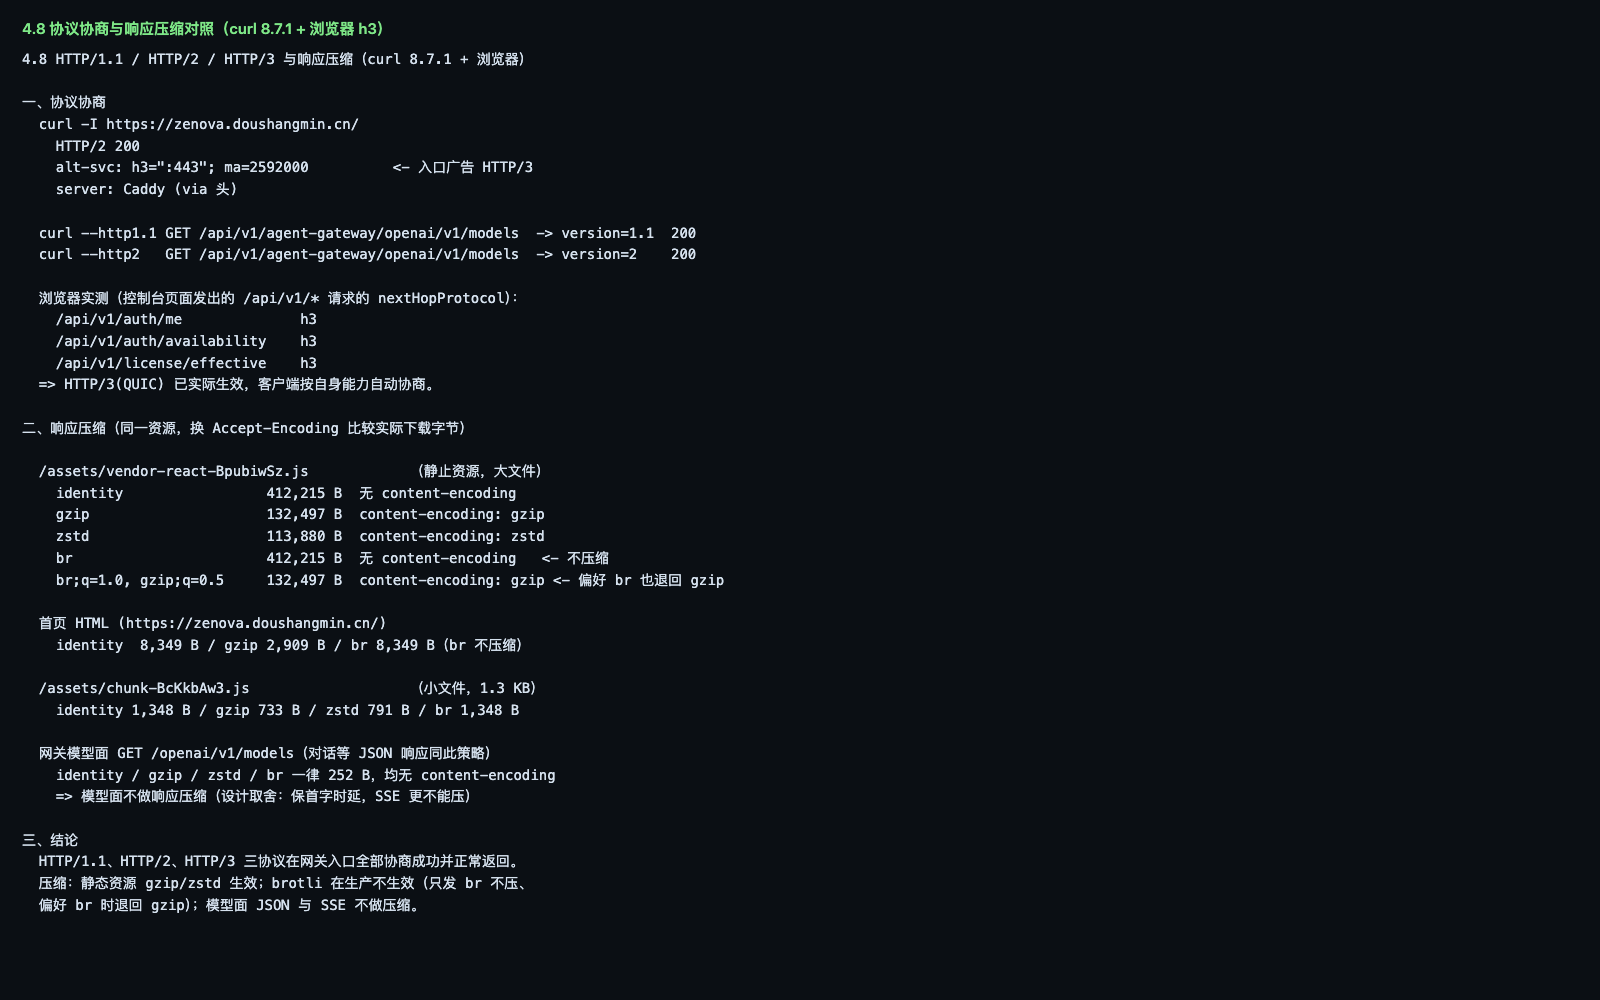
HTTP 版本与端口:入口同时支持 HTTP/1.1、HTTP/2 与 HTTP/3(QUIC),响应头 alt-svc: h3=":443" 告知 HTTP/3 可用,客户端按自身能力自动协商。对外只开放 443(80 端口自动跳转到 443);本产品不强制 TLS,内网部署时按部署文档调整监听端口与协议,不要在网关前另加一层会改写请求头的代理。
响应压缩:静态页面资源按 Accept-Encoding 返回 gzip 或 zstd;模型调用接口(非流式 JSON 与 SSE 流)按设计不做压缩,以降低首字延迟,因此对话响应没有 content-encoding 属正常现象。
WebSocket:仅用于实时语音会话(/openai/v1/realtime),不是通用的 WebSocket 代理。握手缺凭据或凭据错误时返回 401;凭据有效时返回 101 并回显子协议 realtime,随后收到 session.created 事件。浏览器端可先用长期密钥调用 POST /realtime/client_secrets 换取短期临时令牌再握手,不要把长期密钥放进前端。
10.8 厂商原生路径
网关提供 OpenAI、Anthropic、Gemini 三家推理类原生路径,按上游协议重新编码后转发,同样经过鉴权、计量与调用记录。
| 可用(返回 200,返回各家原生结构) | 不提供 |
|---|---|
| :-- | :-- |
GET /openai/v1/models、GET /openai/v1/models/{id} | POST /openai/v1/moderations(404) |
POST /openai/v1/chat/completions、POST /openai/v1/responses | POST /openai/v1/assistants(404) |
POST /anthropic/v1/messages、GET /anthropic/v1/models | GET /openai/v1/files(405) |
POST /gemini/v1beta/models/{m}:generateContent、GET /gemini/v1beta/models | POST /anthropic/v1/messages/count_tokens(404) |
| — | POST /gemini/v1beta/models/{m}:countTokens(404) |
即只有模型推理类路径可用;内容审核、Assistants、文件、Token 计数等管理类接口不提供。需要把任意 HTTP 路径原样转发到某个后端时,由管理员把该后端登记为「API 服务」后经其入口调用,见 API 服务相关章节。
注意:原生路径不是字节级透传。请求详情里「客户端请求」是原生结构、「发往上游的请求」是上游实际格式,网关在中间做了协议转换。
10.9 官方 SDK 与编程客户端
10.9.1 各语言的官方 SDK
任何语言都可直接使用各厂商的官方 SDK,只改 Base URL 与密钥,对话、流式、工具调用往返的行为与直连官方接口一致。Python 示例见 10.2、10.3;产品不自动生成多语言 SDK,其余语言按各厂商官方 SDK 自行配置:
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://<网关地址>/api/v1/agent-gateway/openai/v1",
  apiKey: process.env.ZENOVA_API_KEY,
});

const stream = await client.chat.completions.create({
  model: "<模型名>",
  messages: [{ role: "user", content: "从 1 数到 5" }],
  stream: true,
});
for await (const chunk of stream) {
  process.stdout.write(chunk.choices[0]?.delta?.content ?? "");
}
client := openai.NewClient(
option.WithBaseURL("https://<网关地址>/api/v1/agent-gateway/openai/v1"),
option.WithAPIKey(os.Getenv("ZENOVA_API_KEY")),
)10.9.2 编程客户端
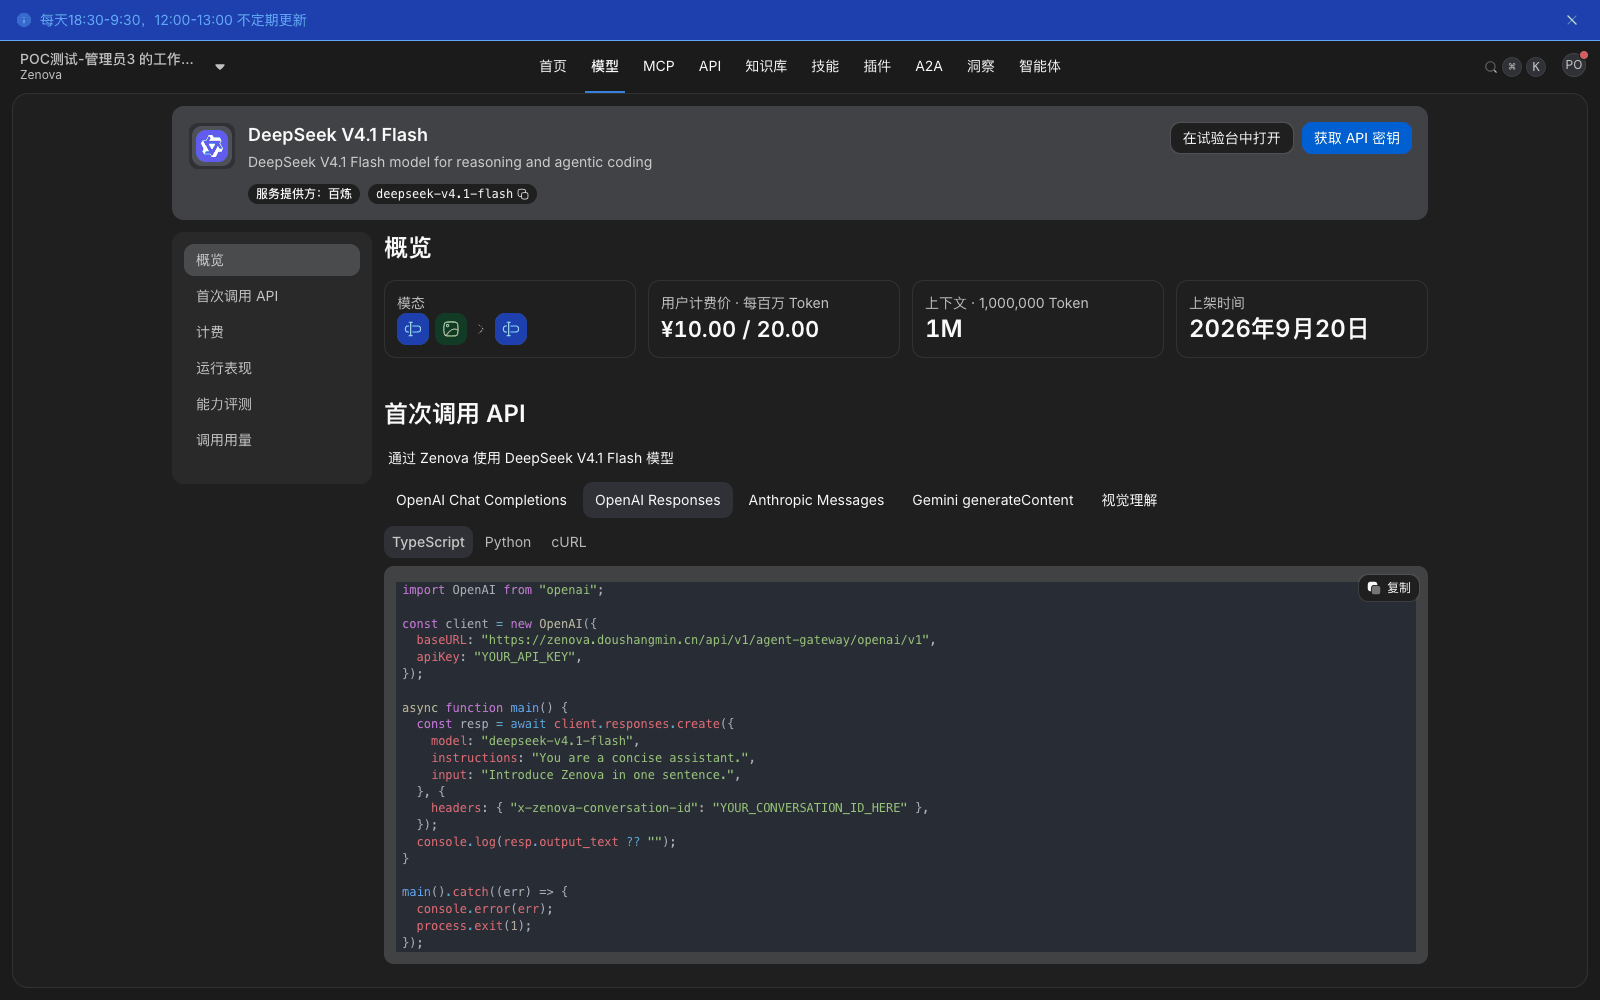
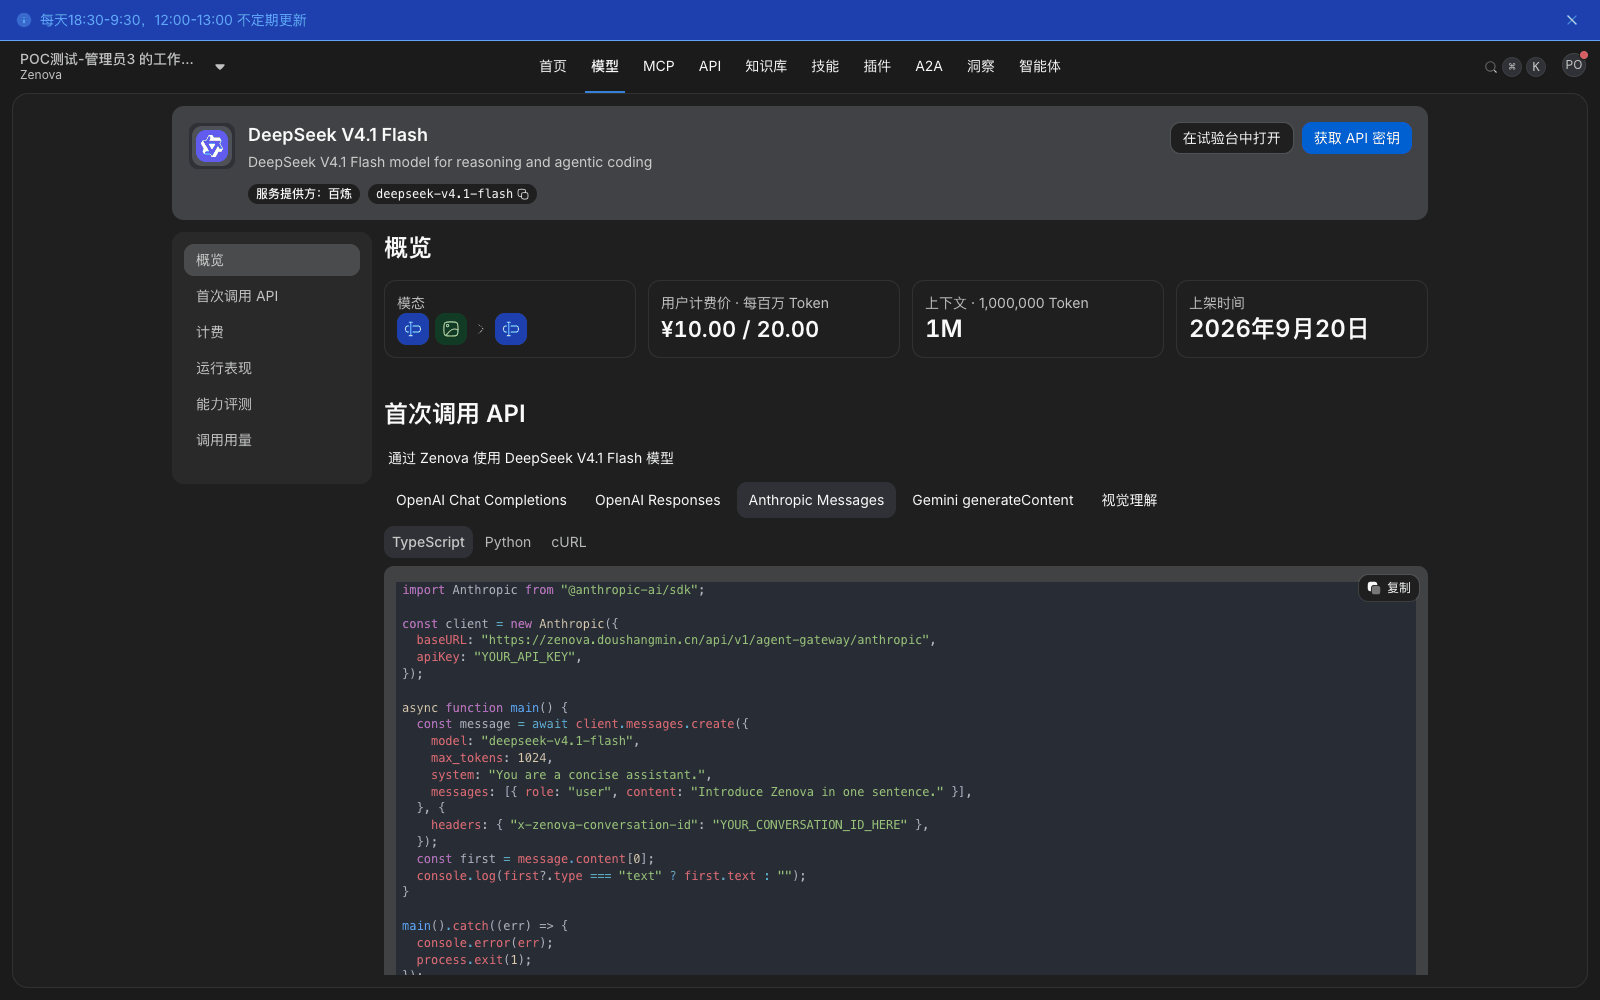
模型详情的「首次调用 API」为三个编程客户端给出了可直接复制的接入配置(<网关地址> 从模型详情直接复制):
| 客户端 | 使用的协议 | 配置要点 |
|---|---|---|
| :-- | :-- | :-- |
| Claude Code | Anthropic Messages | ANTHROPIC_BASE_URL、ANTHROPIC_API_KEY;地址到 /anthropic 为止 |
| Codex | OpenAI Responses | OPENAI_BASE_URL、OPENAI_API_KEY,以及 ~/.codex/config.toml 配置段(wire_api = "responses") |
| Gemini CLI | Gemini generateContent | GOOGLE_GEMINI_BASE_URL、GEMINI_API_KEY;地址到 /gemini 为止 |
| OpenCode | OpenAI Chat Completions | 项目内 opencode.json,provider 用 @ai-sdk/openai-compatible,自行填 baseURL 与密钥 |
export ANTHROPIC_BASE_URL="https://<网关地址>/api/v1/agent-gateway/anthropic"
export ANTHROPIC_API_KEY="<YOUR_API_KEY>"
model = "<模型名>"
model_provider = "zentrix"
[model_providers.zentrix]
name = "Zentrix Gateway"
base_url = "https://<网关地址>/api/v1/agent-gateway/openai/v1"
env_key = "OPENAI_API_KEY"
wire_api = "responses"你会看到:客户端能读取工作目录中的文件、修改代码并把改动落盘,即工具调用往返已经打通。运行总览的「提示词缓存 · 按客户端」表中会出现对应客户端名称。
注意
- 地址只填到协议前缀,不要自己再加
/v1/messages或/v1beta/models/...,客户端会补全。 - Codex 默认使用只读沙箱,非交互运行时需按 Codex 自身的沙箱与审批策略配置,否则模型只给建议不落盘,这不是网关问题。
- Claude Code 会优先使用环境中的
ANTHROPIC_AUTH_TOKEN;终端里残留其他服务的该变量时先清除,再用ANTHROPIC_API_KEY。 - 想在记录里按客户端区分,需在创建密钥时就把「挂到哪个客户端」设为对应类型;否则记录显示「未知客户端」。
- OpenCode 没有专门的接入说明页,按 OpenAI 兼容方式自行写
opencode.json;使用 ZenSwitch 的成员可由它自动下发。
10.10 幂等键与安全重试
适用场景:网络中断或超时后,无法判断上一次请求是否已被处理。携带幂等键重发,可以避免重复调用上游、重复计费。
用法:在请求头中携带 Idempotency-Key: <唯一键>,同一次逻辑请求的所有重试使用同一个键。
curl https://<网关地址>/api/v1/agent-gateway/openai/v1/chat/completions \
  -H "Authorization: Bearer <YOUR_API_KEY>" \
  -H "Idempotency-Key: order-8842-retry-1" \
  -H "Content-Type: application/json" \
-d '{"model": "<模型名>", "messages": [{"role": "user", "content": "只回复数字 9"}], "max_tokens": 30}'取值要求:1~256 位可打印 ASCII 字符。幂等范围为「凭据 + 键 + 接口」,不同密钥或不同接口使用相同键互不影响。
你会看到
- 键不合法(例如长度超出上限)时,在派发上游前返回 400
VALIDATION_FAILED,不产生费用。 - 同键但请求体不同时可能返回 409
RESOURCE_CONFLICT。 - 网关不会在响应头里标注「本次是回放还是新结果」,回放与否要通过调用记录核对。
注意
- 幂等键适用于可以安全重试的写操作与计费敏感调用。生成类请求本身带随机性,重试时不要假设一定能拿回同一段文本。
- 要确认是否真的只算一次费用,请到「运行总览 › 请求」按时间与凭据核对同键请求的条数与上游尝试次数,不要只看响应内容是否相同。
- 不要用一个固定键给所有请求复用。键的含义是「这一次逻辑请求」,复用到不同请求上会引入冲突。
10.11 按模型参数规范自动适配
适用场景:同一份代码要发给多个模型,而各模型对参数的支持范围不同(例如部分推理模型不接受 temperature 或 tool_choice)。
你会看到
- 目标模型支持的参数照常转发;不支持的参数自动去掉,推理档位按模型能力降级。网关只做去除与降级,不会为你补充没提供的参数。
- 有字段被去掉时,响应头
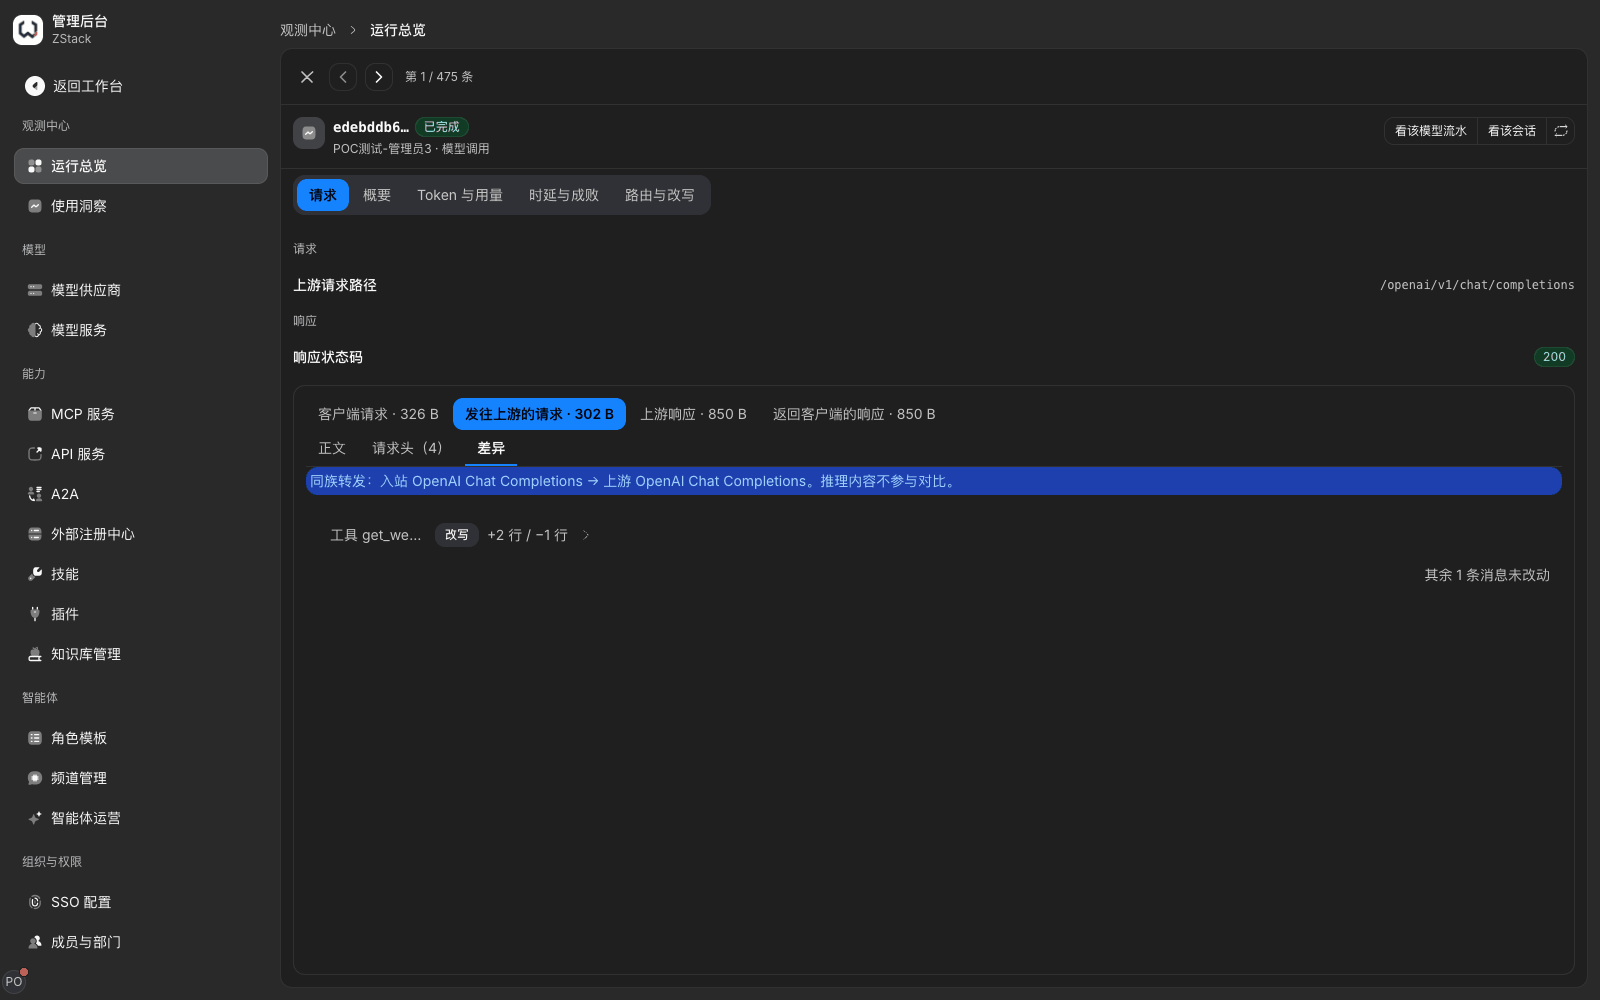
x-zenova-conversion-dropped以逗号分隔列出这些字段,例如openai_chat.temperature,openai_chat.tool_choice;全部照常转发时不带该响应头。 - 在「运行总览 › 请求详情 › 请求 › 发往上游的请求 › 差异」中可以逐字段看到改写内容,例如工具定义被补齐
strict字段、其余消息未改动。
注意
- 模型参数能力由平台内置目录维护,管理员无需配置,也不支持自定义改写规则。
- 业务代码应把「参数是否被丢弃」当作可观测信号:
x-zenova-conversion-dropped非空时,说明你依赖的某个参数在这个模型上没有生效,需要换模型或调整调用方式。 - 差异页签提示「报文加载失败」时点「重试」即可重新拉取,不影响该次调用的结果与计量。
10.12 请求体与 Token 上限
| 项目 | 默认上限 | 超出时 |
|---|---|---|
| :-- | :-- | :-- |
| 请求体大小 | 32 MiB | 413,统一 JSON 错误体 |
| 语音转写文件 | 25 MiB | 413 |
| 请求结构 | 必须是合法 JSON 对象,且含所调接口的必填字段(如 model、messages),字段类型正确 | 在派发上游前返回 400 |
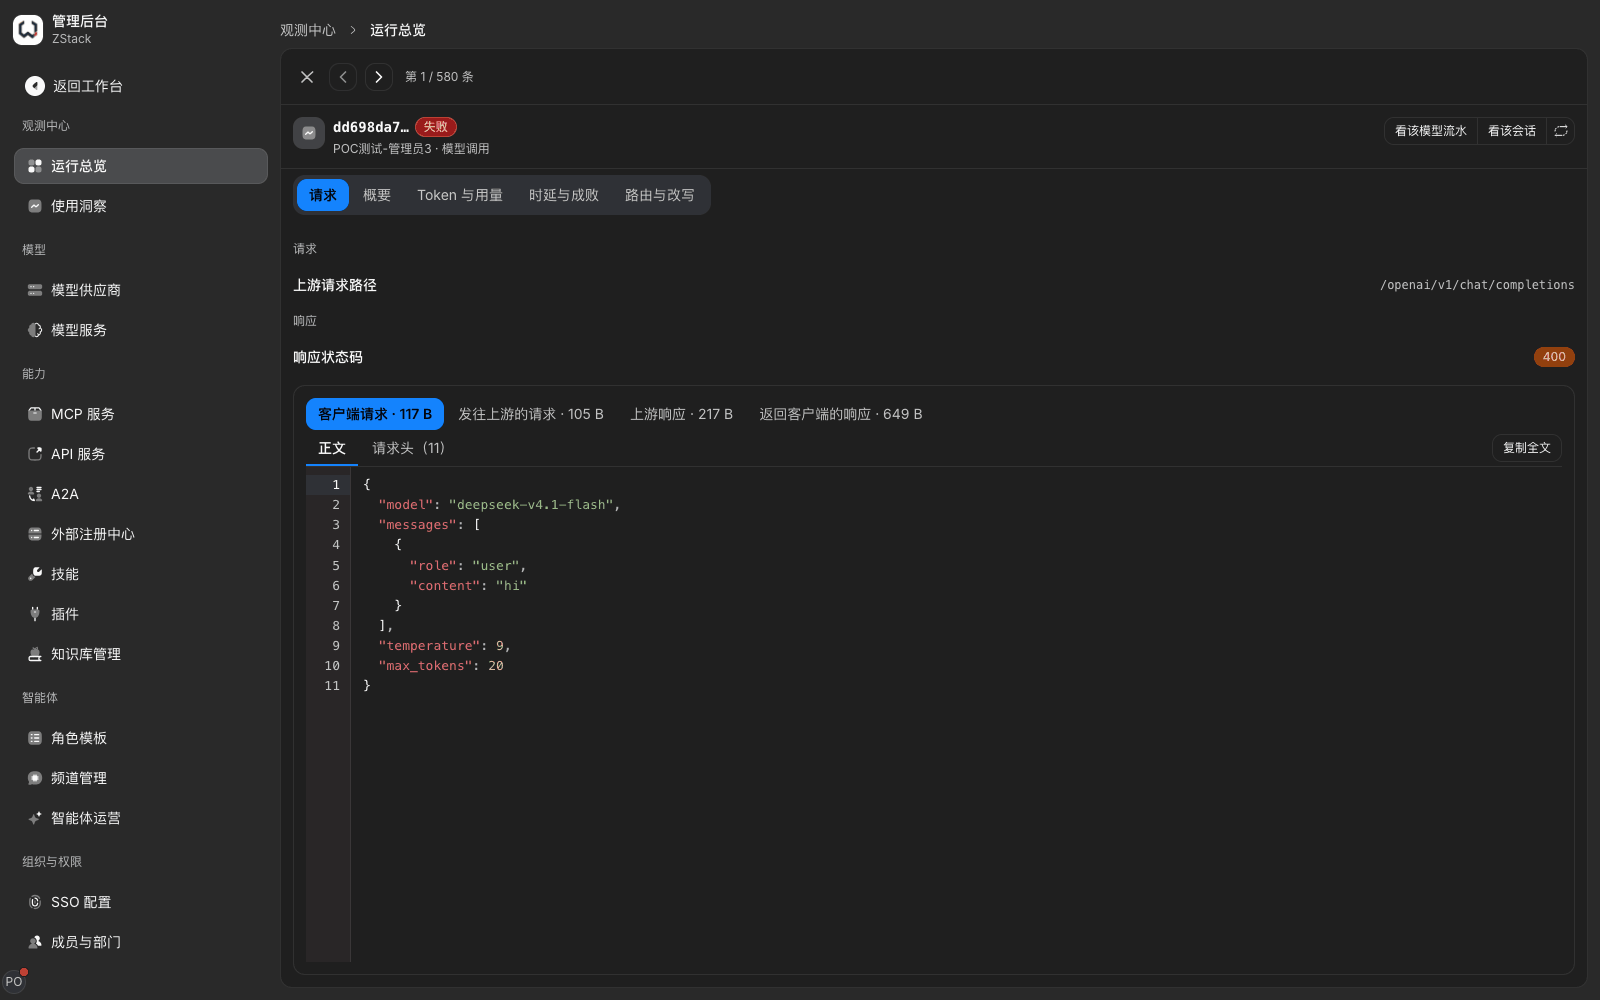
结构不合法时统一返回 400 LLM_REQUEST_BODY_INVALID,文案为「The request body is not valid JSON or does not match the request structure of this API.」,并带 param(如 messages、messages[0].role、max_tokens)与 details.field_violations 说明具体原因。缺 model、缺 messages、messages 写成字符串、role 非法、max_tokens 类型错误、非法 JSON、请求体是数组,都属于这一类。被拒的请求同样记入调用记录且不计费。
管理员可在流量规则中为指定的模型、模型分组、调用方、部门或请求头组合配置更严格的上限:「请求体大小上限」超出时返回 413,详情为 request_body_limit_exceeded;「单次请求 Token 上限」输入超出时返回 400 VALIDATION_FAILED,详情为 token_limit_input_exceeded,输出上限则把请求的 max_tokens 改写为不超过该值,超出部分以 finish_reason: length 结束。被规则拒绝的请求带 deniedBy: routePolicy,请求详情「路由与改写 › 命中记录」中显示命中的规则名。
注意
- 网关不校验参数数值范围(例如温度是否在允许区间)。这类参数会被转发到上游,由上游拒绝并把原因写在
upstream_message中;业务方应在上游一侧按模型文档先做范围校验。 - 流量规则的上限按条件匹配生效,配置后先用一条已知规模的请求验证实际效果,再放到生产。
- Token 数按网关估算,与上游账单口径可能有细小差异,限额判断以网关估算为准。
10.13 统一错误格式
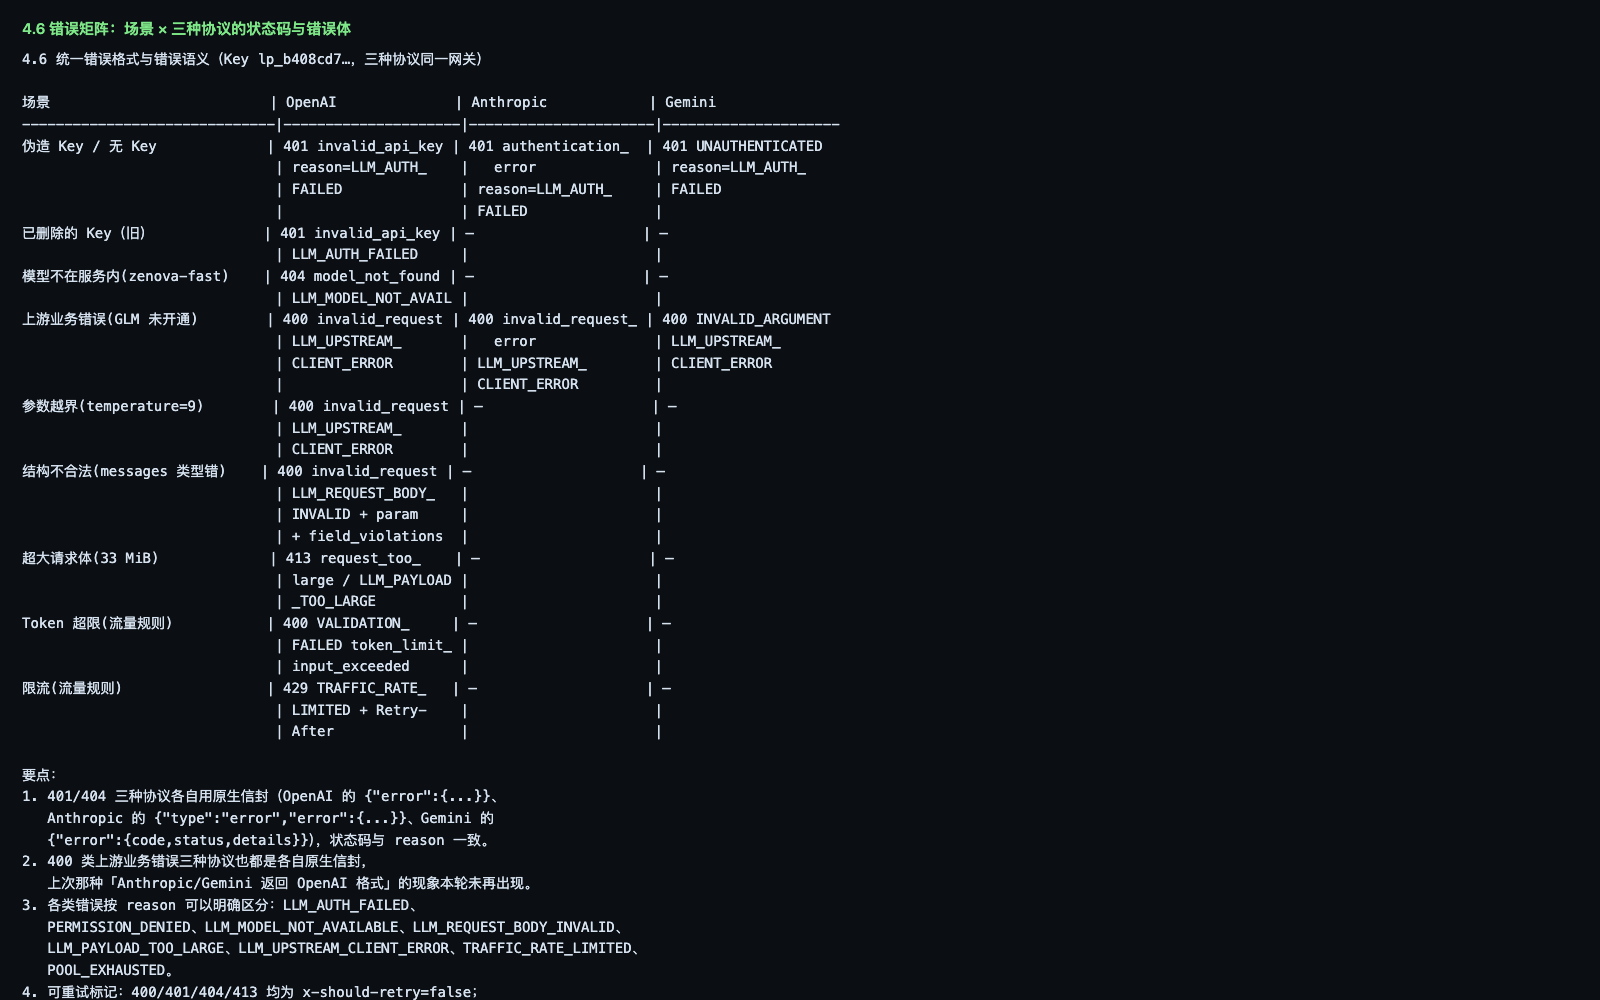
错误按调用方使用的协议返回各自的原生结构,三种协议携带同一个稳定的原因码 reason:
| 协议 | 错误体结构 |
|---|---|
| :-- | :-- |
| OpenAI | {"error": {"message", "type", "code", "reason"}} |
| Anthropic | {"type": "error", "error": {"type", "message", "reason"}} |
| Gemini | {"error": {"code", "message", "status", "details"}} |
业务系统应按 reason 处理错误,不要解析 message 文本(它是随版本调整的说明文字,多为英文)。
常见场景与原因码
| 场景 | HTTP | reason | 可重试 |
|---|---|---|---|
| :-- | :-- | :-- | :-- |
| 凭据缺失、无效、已删除 | 401 | LLM_AUTH_FAILED | 否 |
| 密钥被禁用、无权执行该调用 | 403 | PERMISSION_DENIED | 否 |
| 模型不存在或不在本密钥的服务中 | 404 | LLM_MODEL_NOT_AVAILABLE | 否 |
| 模型不支持所调用的接口 | 400 | MODEL_ENDPOINT_UNSUPPORTED | 否 |
| 请求结构不合法 / 请求参数不合法 | 400 | LLM_REQUEST_BODY_INVALID / VALIDATION_FAILED | 否 |
| 请求体超过上限 | 413 | LLM_PAYLOAD_TOO_LARGE | 否 |
| 上游拒绝请求参数 | 400 | LLM_UPSTREAM_CLIENT_ERROR | 否 |
| 额度池用尽 | 429 | POOL_EXHAUSTED | 否 |
| 命中流量规则限速 | 429 | TRAFFIC_RATE_LIMITED | 是,按 Retry-After |
| 上游供应商不可用 | 503 | LLM_PROVIDER_UNAVAILABLE | 是 |
响应头
x-request-id:网关侧请求标识,向管理员反馈问题时附上该值。x-should-retry:true或false,表示重试是否可能改变结果。400、401、404、413 均为false。Retry-After:仅在错误可重试且网关知道等待时长时返回。
处理建议:先看 HTTP 状态与 reason 确定类别,再看 x-should-retry——为 false 时重试不会改变结果,应修改请求或凭据。调用方错误(400、401、403、404、413)改请求或凭据;额度类错误(429 POOL_EXHAUSTED)联系管理员调整配额;限速按 Retry-After 等待后重试;上游类错误(502、503、504)稍后重试,持续出现时联系管理员检查供应商。
注意
- 错误信息中不包含上游地址、上游密钥或内部堆栈。
- 上游业务错误与参数越界会把上游原文放进响应(含上游请求标识),便于定位上游侧问题。若不宜出现在客户端,请在服务端记录错误、只把
reason返回前端。
能力说明
| 不提供的能力 | 替代做法 |
|---|---|
| :-- | :-- |
| gRPC 代理与转码、TCP/UDP 四层代理 | 网关是七层 HTTP 接口,按 10.1~10.3 调用;需要访问其他协议的后端时登记为「API 服务」后经其入口转发 |
| 通用 WebSocket 代理 | WebSocket 只用于实时语音会话,其他双向通信改用 HTTP 流式 |
异步批量任务(/batches、/files)与闲时调度 | 模型不提供「批处理」用途;多道判断题用同步的批量判断接口(10.6),大批量离线任务在客户端分批并发调用 |
| 管理类原生接口(内容审核、Assistants、文件、Token 计数) | 见 10.8 的对照表 |
| 流式续写 | 输出被截断时网关明确标注为失败,由客户端重新发起请求 |
| 自定义的字段级校验规则 | 网关只校验 JSON 合法性与必填字段;额外限制用流量规则(10.12) |
| 按路由关闭认证或改用其他认证方式 | 所有模型与 MCP 路由一律要求 API 密钥 |
| 自动生成多语言 SDK | 使用各厂商官方 SDK(10.9) |
| API 多版本并存、版本路由、废弃通知与下线过渡期 | 需要灰度切换时,用流量规则按请求头或路径分流到不同上游 |
---