17. 查看用量并控制成本
完整版章节。内容按 2026.10 主线代码与运行环境界面核对;具体入口以当前许可、账号权限和交付环境为准。
本章内容:本章面向平台管理员、负责费用的运营人员,以及需要核对本人消费的成员。读完后你能做到四件事:在「运行总览」找出钱花在哪些模型、部门、成员和接入凭据上;说清 Token 与费用记在谁头上、为什么有些调用归不到人;用标签与终端用户标识把费用拆到业务场景和最终使用者;用配额在调用发生时把钱挡住。逐项拆账与定价快照见第 18 章。
17.1 看懂消耗排行与高消耗凭证
适用场景:月初复盘或费用异常增长时,先回答「钱主要花在哪里、是哪一把密钥在跑量」。
前提:账号为租户管理员,或具备观测、财务类角色;模型已在模型供应商处定价(第 5 章),未定价的调用仍计入次数与 Token,金额记为 0。
操作步骤
- 进入「管理后台 › 观测中心 › 运行总览」,默认打开「总览」页签,在工具栏选择时间范围(默认「最近 7 天」)。
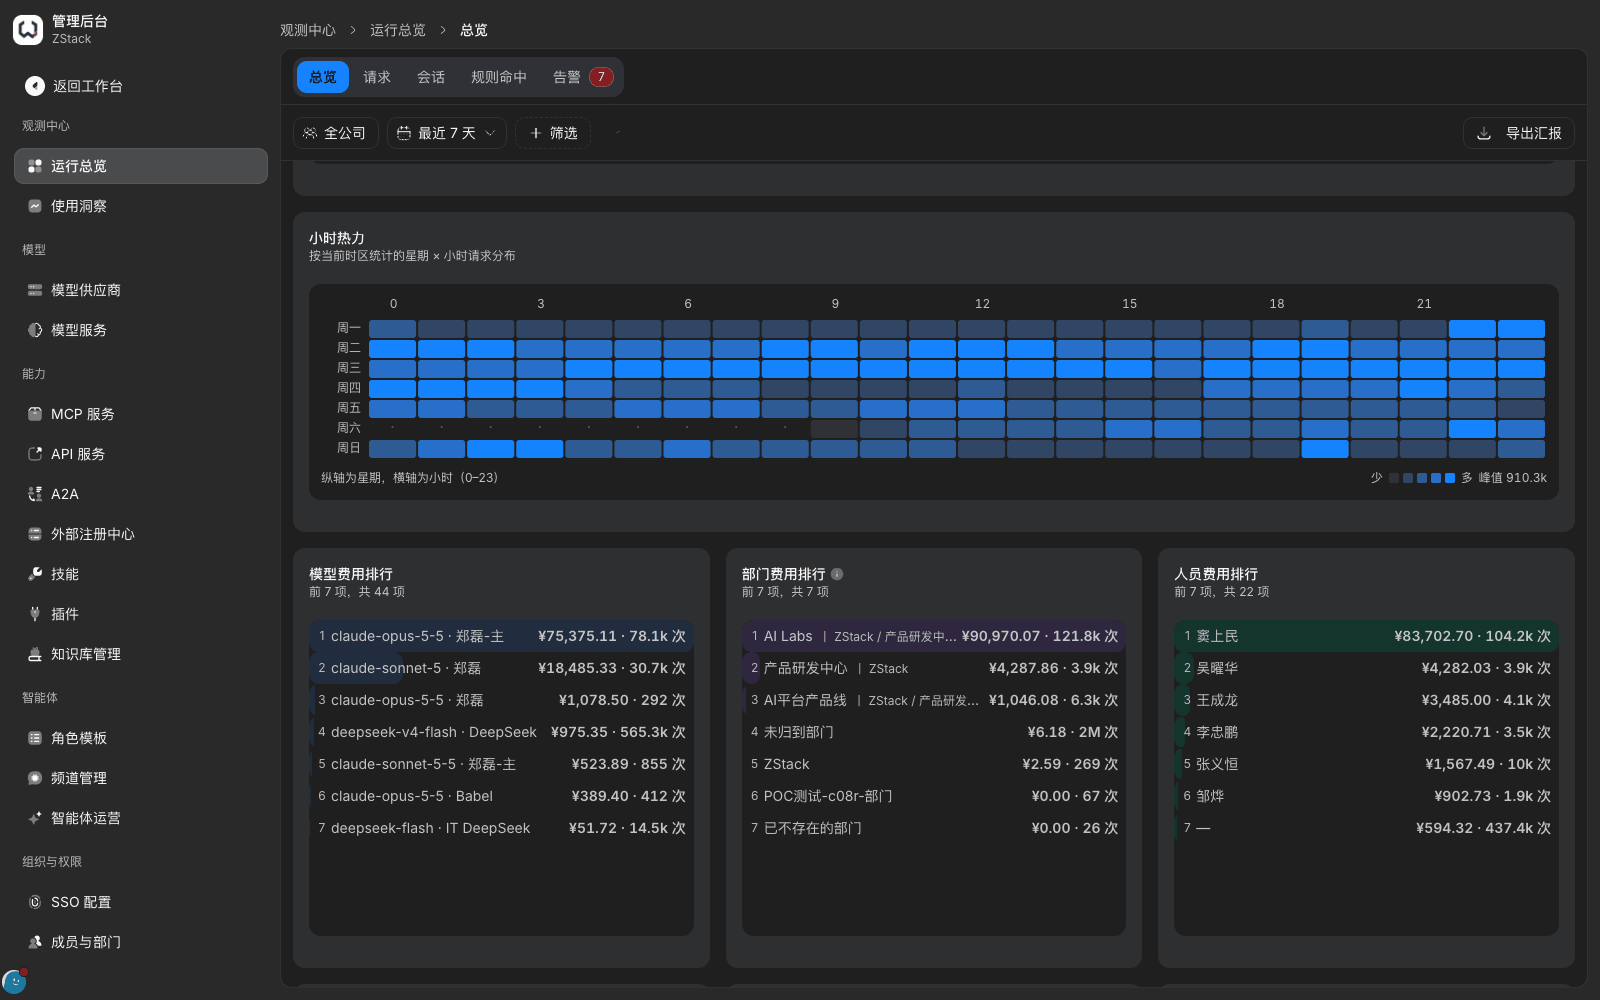
- 向下滚动到「模型费用排行」「部门费用排行」「人员费用排行」三张表,每项同时给出金额与调用次数。点击任意一项会切到「请求」页签并带上对应筛选,可逐条核对。
- 要判断消耗由哪个业务系统在跑量时,滚到「调用流向」面板:它按「接入凭据 → 客户端 → 模型 → 供应商」四列展示分布,每列只显示调用量最高的若干项,其余合并为「其他 N 个」。
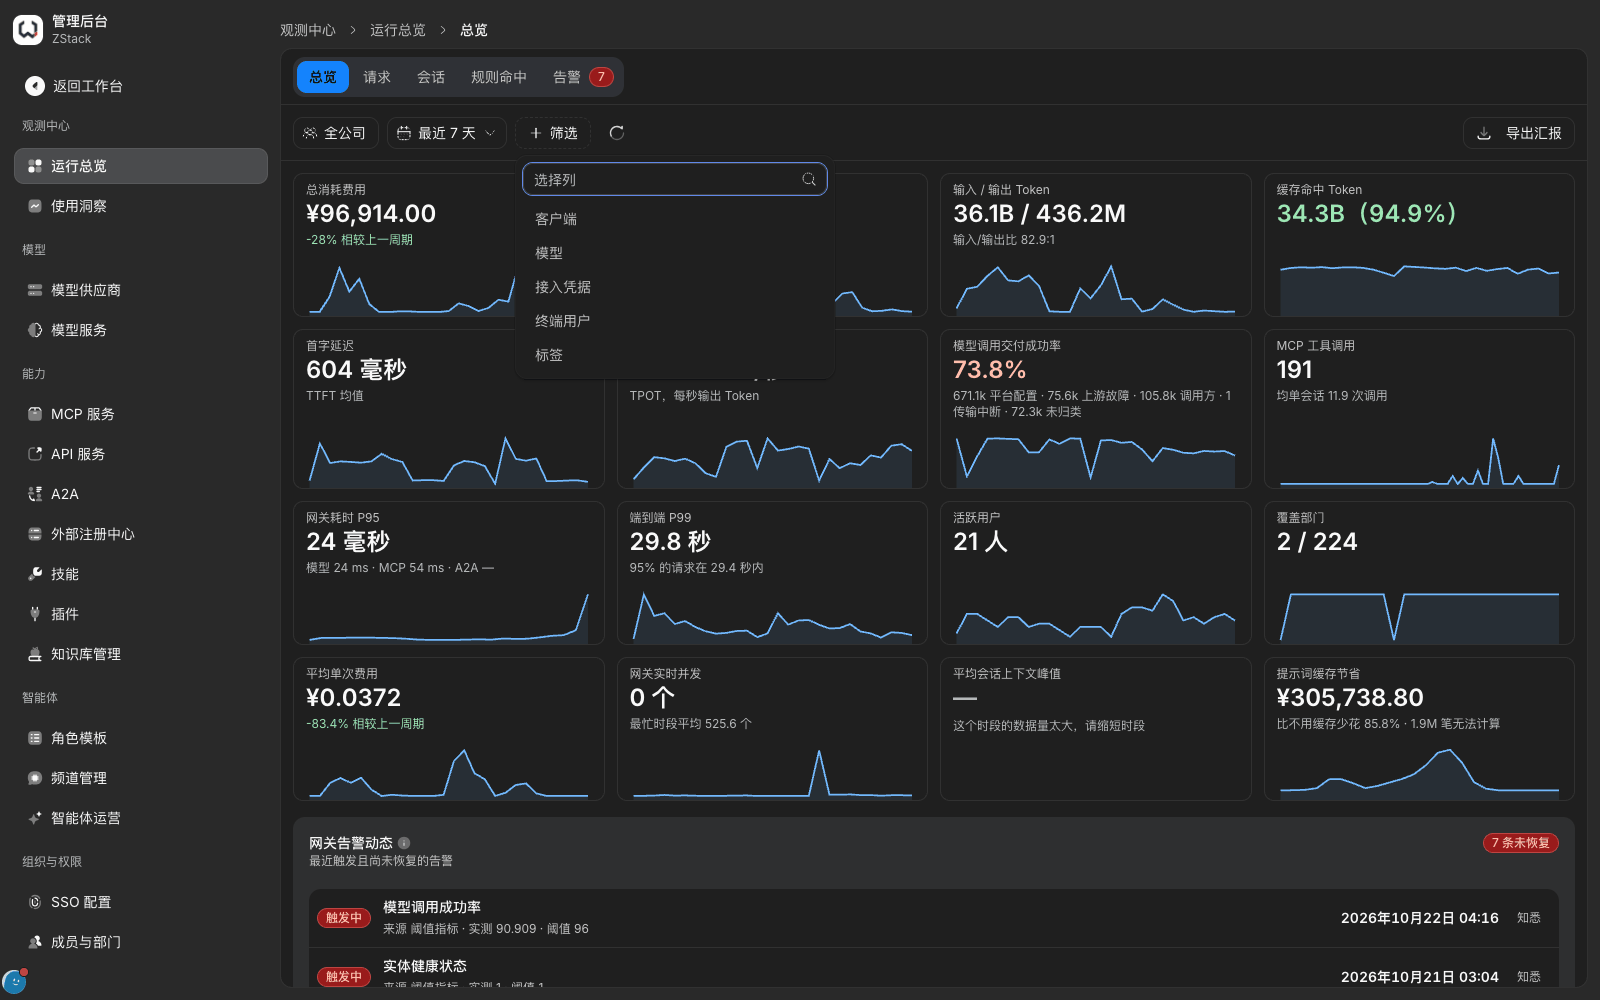
- 回到工具栏点「筛选」,添加「接入凭据 = 该凭据」,整页指标收敛到这把凭据,「总消耗费用」才是它的费用量级。
你会看到
- 模型排行的项名形如「模型名 · 供应商账号」,最多展示前若干项并标注总项数。
- 「调用流向」的节点名形如「所属人 · 凭据名」,统计的是调用次数而非金额或 Token;「未经接入凭据」「未知客户端」「未知模型」「未分配供应商」四类节点收纳缺少对应信息的调用。
注意
- 「调用流向」按次数计,判断某把凭据花了多少钱要看第 4 步收窄后的指标卡;节点名里的「所属人」是凭据归属人,不等于每次调用的实际操作人。
- 排行只提供金额维度,按 Token 比较的做法见本章能力说明。
17.2 核对 Token 与费用归属
适用场景:判断消耗是被输入还是输出驱动的、请求是否变多、缓存是否发挥作用,以及核对某一笔调用记在谁头上。
操作步骤
- 在「总览」顶部读指标卡:「总 Token 消耗量」副标题为请求总次数,「输入 / 输出 Token」分列并给出比值,「缓存命中 Token」附命中率。
- 读「提示词缓存节省」卡片,它给出与不使用缓存相比少花的金额与比例,以及无法计价的调用数。
- 用「筛选」依次添加模型、客户端、接入凭据,对比请求次数与 Token 的变化幅度:两者同比例增长说明请求变多,次数不变而 Token 增长说明单次请求变长。
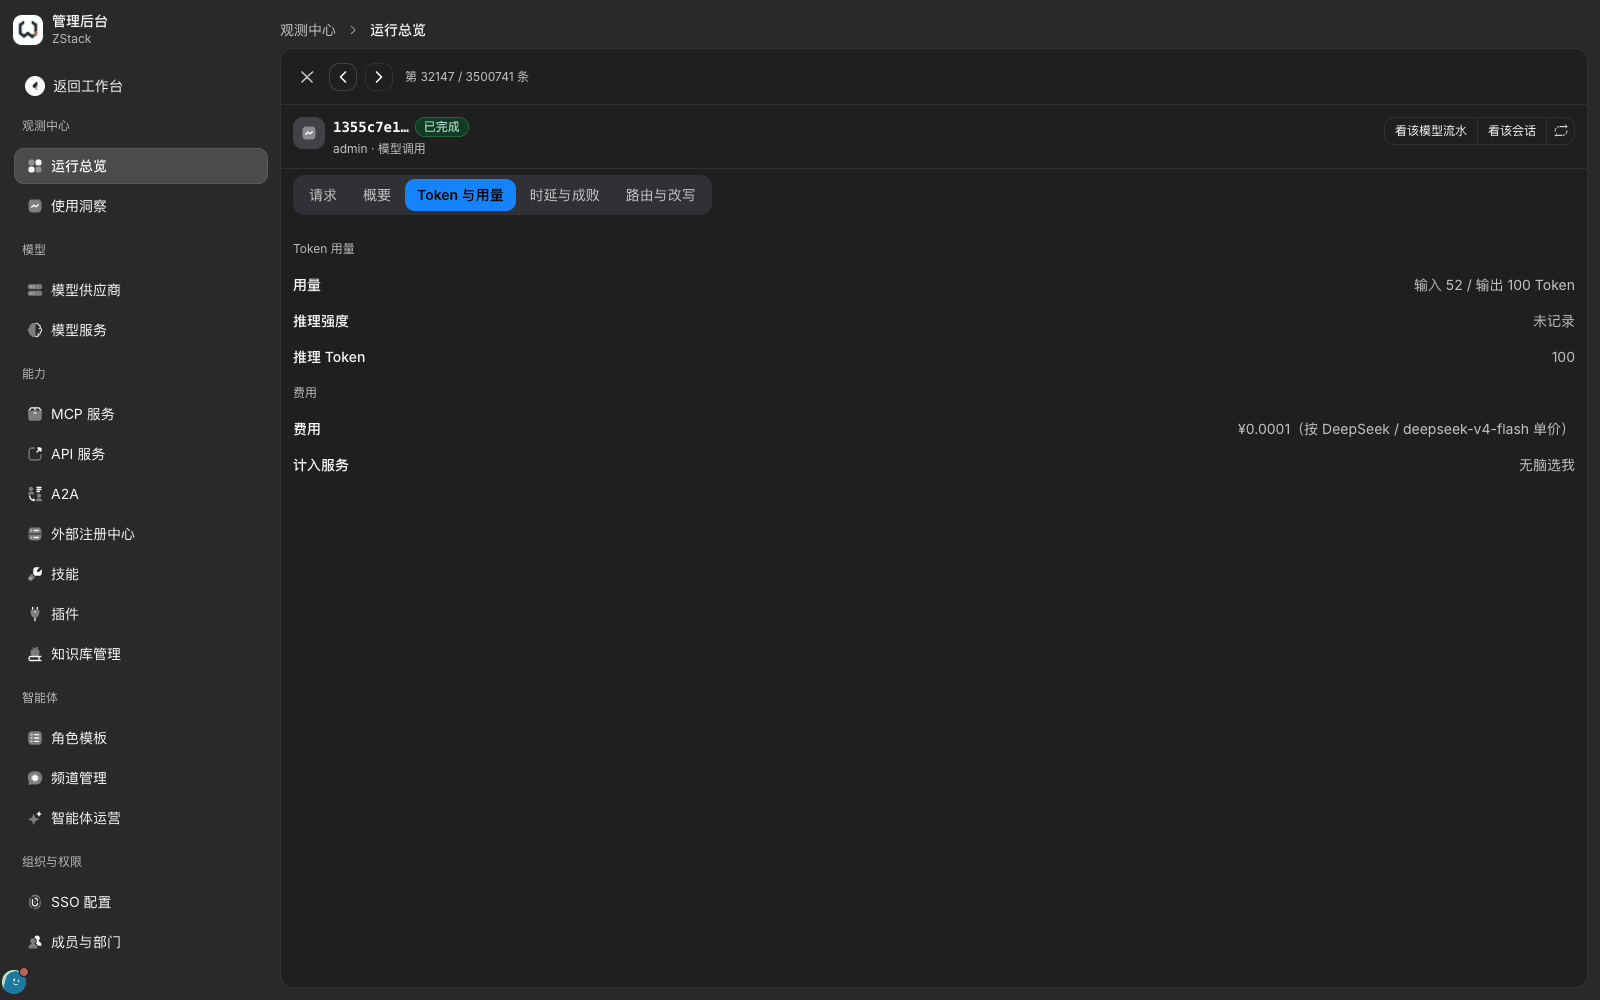
- 打开一条代表性调用,切到「Token 与用量」页签,核对单次用量、推理 Token、费用与计入服务。
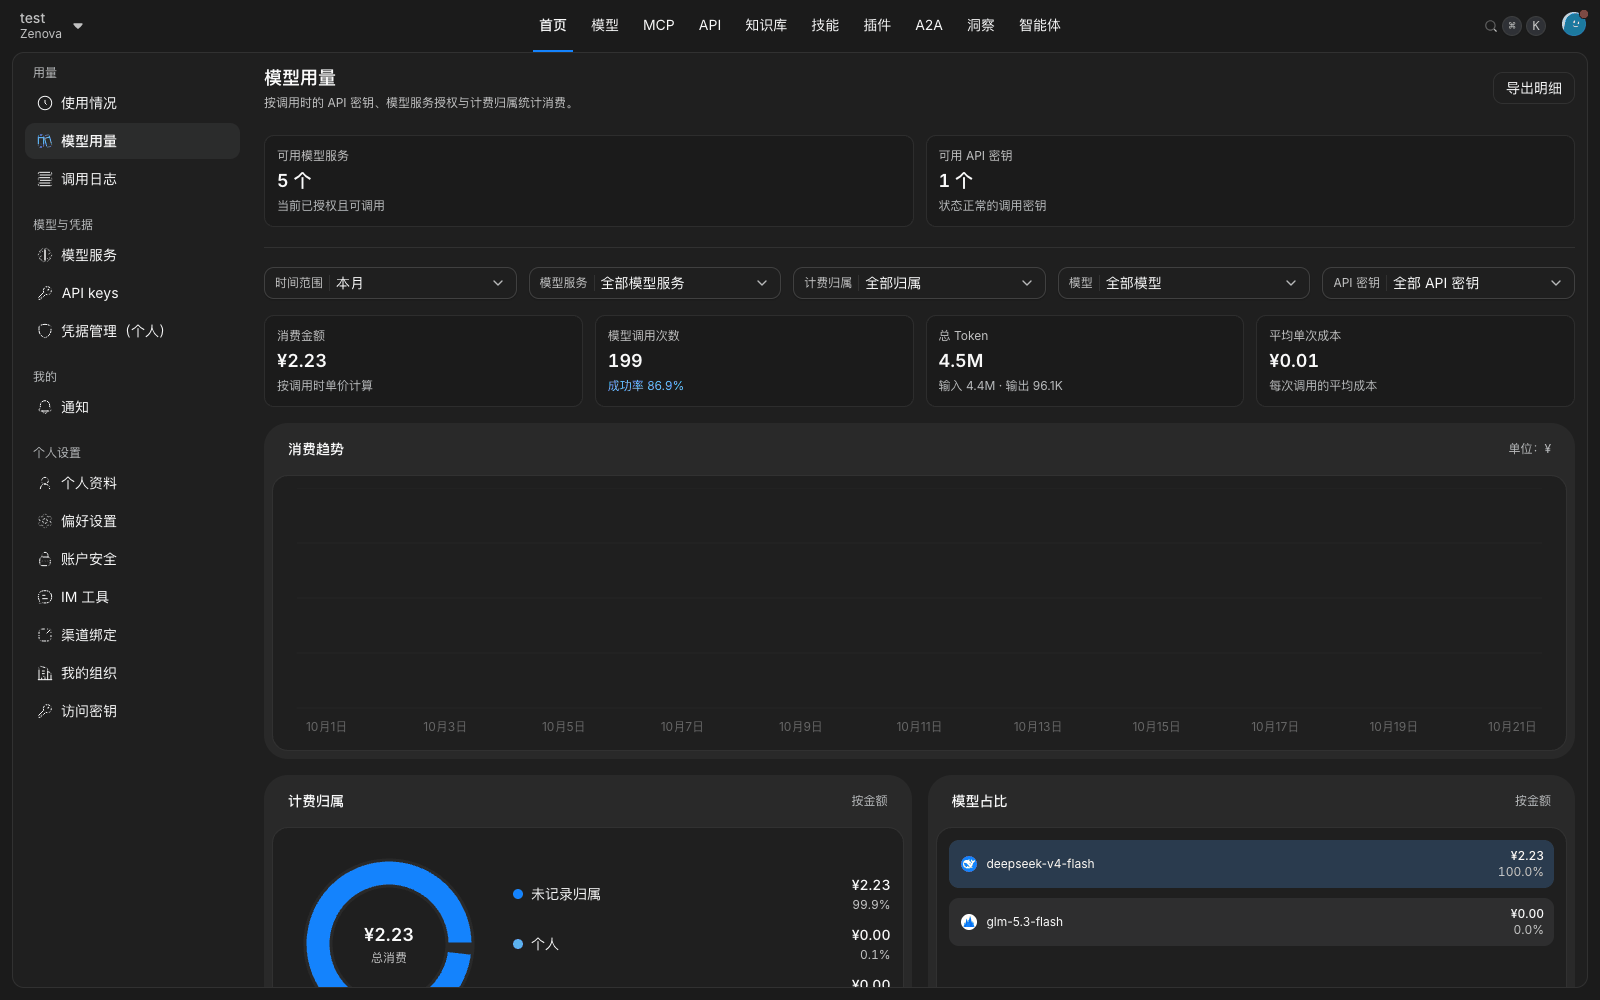
- 成员核对本人消费时,进入工作台左侧「用量 › 模型用量」,选好时间范围(默认本月)后按模型分组、计费归属、模型、API 密钥筛选。
你会看到
- 「输入 / 输出 Token」的比值显著大于 1 说明开销集中在输入侧,通常意味着上下文过长或缓存未命中。
- 「提示词缓存节省」是独立卡片,节省金额不计入「总消耗费用」,两者不能相加。
- 单次调用的费用说明写成「按〈供应商〉/〈模型〉单价」,并注明本次计入哪个模型分组。
- 成员侧的「模型用量」给出可用模型分组数、可用 API 密钥数与四张指标卡(消费金额、调用次数及成功率、总 Token、平均单次成本),下方按计费归属与模型拆分金额。模型未定价时费用记为 0,Token 与次数照常统计。
注意
- 归集口径:每笔调用在调用结束时按当时的有效单价计费,记到发起人、发起人所属部门与所使用的接入凭据上。部门费用一笔只计一次,不向上级部门汇总。
- 无法归属是正常现象。服务账号发起的调用、发起人已离开组织、历史调用缺少归属记录,都会落到「未归到部门」「—(无发起人)」等项。用量汇总有分钟级延迟,核对刚发生的调用以请求详情为准。
17.3 按标签归集费用
适用场景:同一把 API 密钥同时服务多个业务场景,需要按场景出账,而部门与成员的维度切不开。
前提:账号为租户管理员;标签的英文标识用稳定、不含敏感信息的短名,例如 biz_scene。
操作步骤
- 进入「管理后台 › 流量 › 标签」,点击「新建标签」,填写「英文标识」与「中文名」,把「适用范围」选为「调用方」,勾选「允许调用方在请求头中声明」。
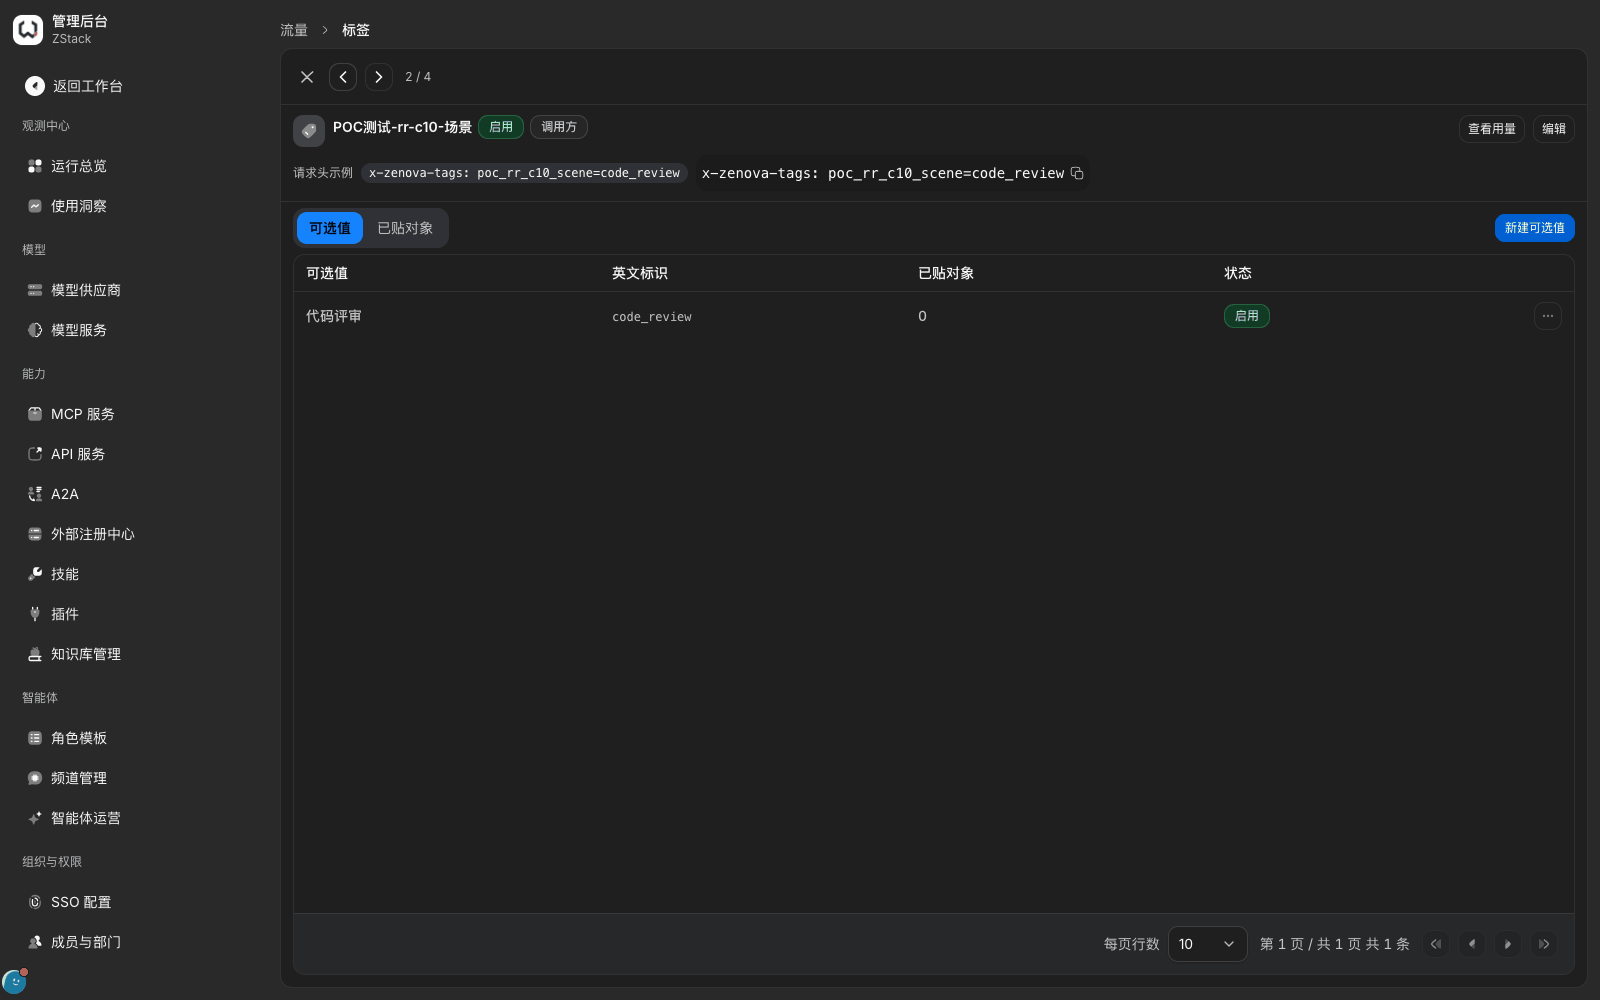
- 打开标签详情页,点击「新建可选值」,逐个添加业务取值。详情页顶部给出的请求头示例可直接交给调用方,形如
x-zenova-tags: biz_scene=code_review:
curl https://<网关地址>/v1/chat/completions \
  -H "Authorization: Bearer <YOUR_API_KEY>" \
  -H "Content-Type: application/json" \
  -H "x-zenova-tags: biz_scene=code_review" \
-d '{"model":"通用对话","messages":[{"role":"user","content":"你好"}]}'- 在标签详情页点右上角「查看用量」,页面跳到「运行总览」并自动带上该标签筛选;常规检索时在「运行总览 › 请求」的「筛选」中添加「标签」,取值分「标签名(任意值)」与「标签名:值」两种粒度。
- 出账文件在「管理后台 › 审计与合规 › 报表导出」生成:新建导出,「数据」选「用量汇总」,「归集方式」选「按标签」并指定标签键,设置频率与范围后提交,任务完成后在列表中下载。
你会看到
- 带标签头的调用正常返回,按标签筛选后列表只剩带该标签的调用;从「查看用量」进入时整页指标收敛为该场景的请求数、Token 与费用。
- 「按标签」导出的文件表头为:归集对象、调用次数、输入 Token、输出 Token、缓存 Token、费用、币种、统计区间。
注意
- 标签只对声明之后的调用生效,不会回溯历史调用,新建后要通知调用方更新请求头,否则费用仍归在「未打标签」。
- 未开放「允许调用方在请求头中声明」的标签键,调用方带了会被拒绝(HTTP 400,
VALIDATION_FAILED,原因码tag_not_declarable),这是有意的拒绝而非静默忽略。声明了不在可选值内的取值则仍然放行,但该次调用只落在「标签名(任意值)」下,不会归到任何一个具体取值。
17.4 按终端用户计量
适用场景:一个业务系统用同一把 API 密钥服务大量最终用户,需要按最终使用者统计次数与费用,而不是只看到一把密钥的总量。
前提:已有一把可用的 API 密钥;业务系统能为每个最终用户生成稳定的内部编号。
操作步骤
- 让业务系统在每次请求中传入终端用户标识,两种方式任选其一,同时出现时以请求头为准:请求头
x-zenova-end-user: <终端用户标识>,或 OpenAI 协议请求体顶层的user字段。 - 在「运行总览 › 总览」点「筛选」,添加「终端用户」条件并选中目标用户,整页指标收敛为该用户的调用量与费用。
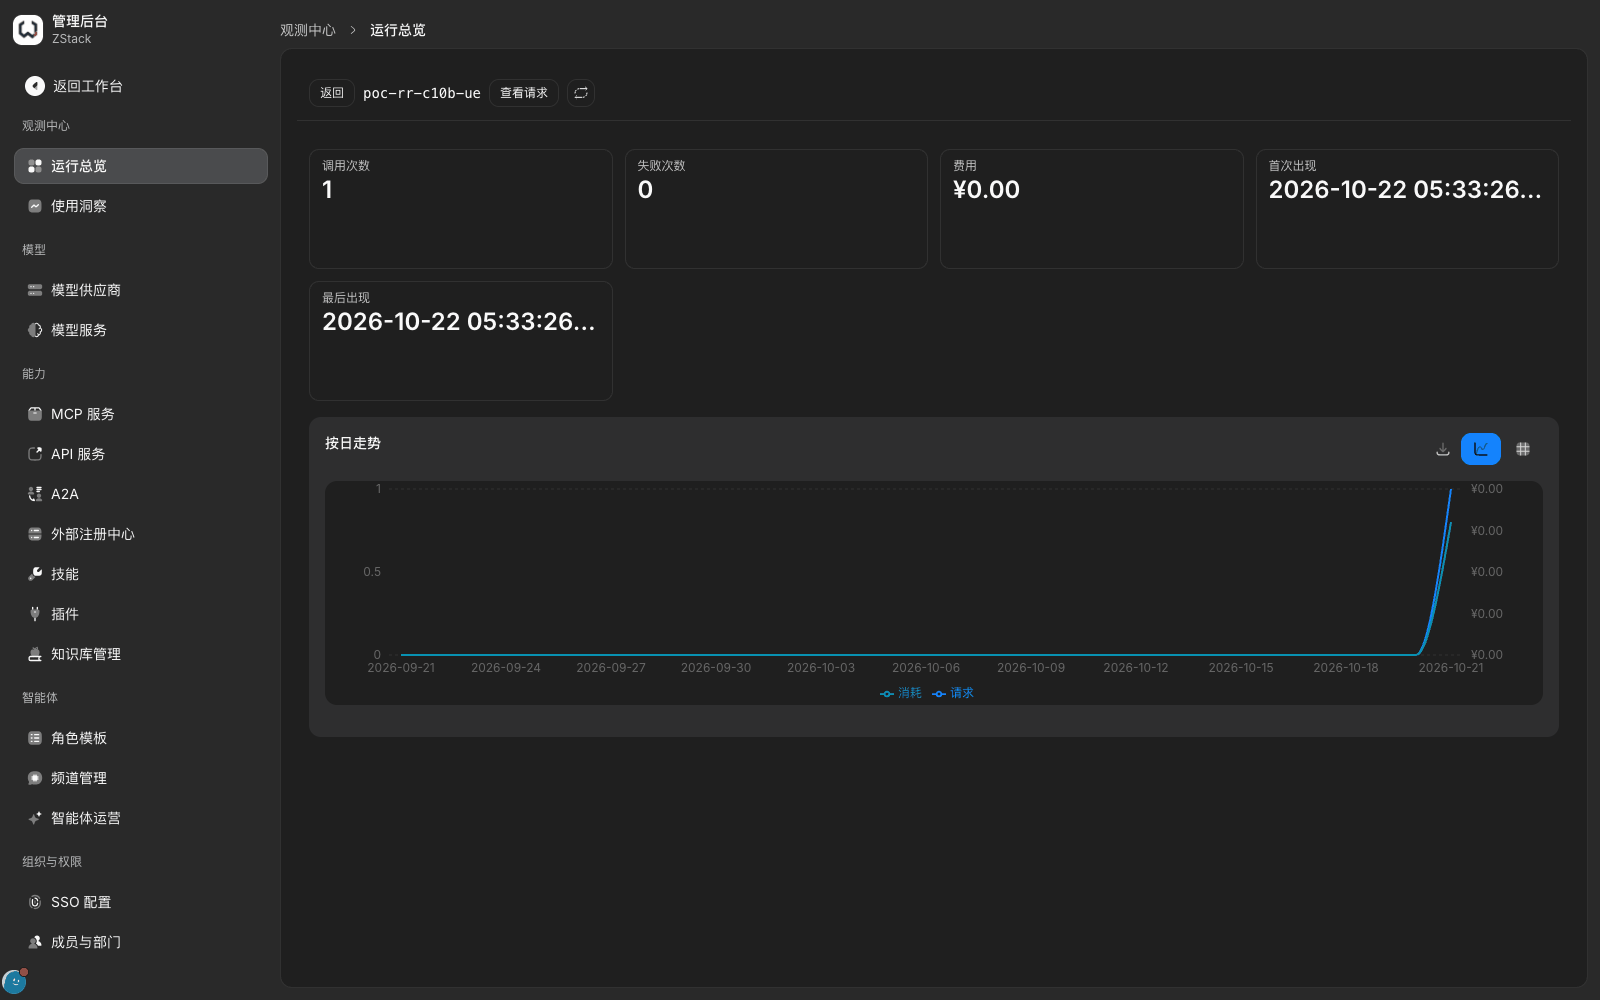
- 打开终端用户详情,读「调用次数」「失败次数」「费用」「首次出现」「最后出现」与「按日走势」。
- 点「查看请求」,跳转到「请求」页签并按该终端用户筛选,逐条核对。
你会看到
- 详情页头的标识即业务系统传入的原值;「按日走势」同时给出消耗与请求两条曲线,可看出该用户是持续使用还是集中在某几天。
- 「查看请求」后列表只包含该终端用户的调用,条数与「调用次数」一致。
注意
- 标识由业务系统自行定义,平台不校验真实性。不要在标识中放手机号、身份证号等敏感信息,用内部编号即可。
- 终端用户与「发起人」不是一回事:发起人是 API 密钥所属的平台成员,终端用户是业务系统转述的最终使用者。
- 「终端用户」筛选按需远程检索候选值,展开时不会预列全部,直接输入完整标识最稳妥。请求详情「概要」页签不单列该字段,要看实际传入的标识请打开「请求」页签的请求头。
17.5 隐性消耗按用途归属
适用场景:员工直接提问的开销好理解,但智能体在后台产生的子代理、上下文压缩、重试等调用同样花钱,需要找出这部分消耗。
前提:调用由平台托管的智能体发起,或会话已开启客户端上报(第 19.3 节)。
操作步骤
- 在「运行总览 › 请求」的「筛选」中添加「用途」,展开可选值:对话、向量、重排、文生图、图片编辑、语音合成、语音转写、判断、视频生成。该字段表示端点用途。
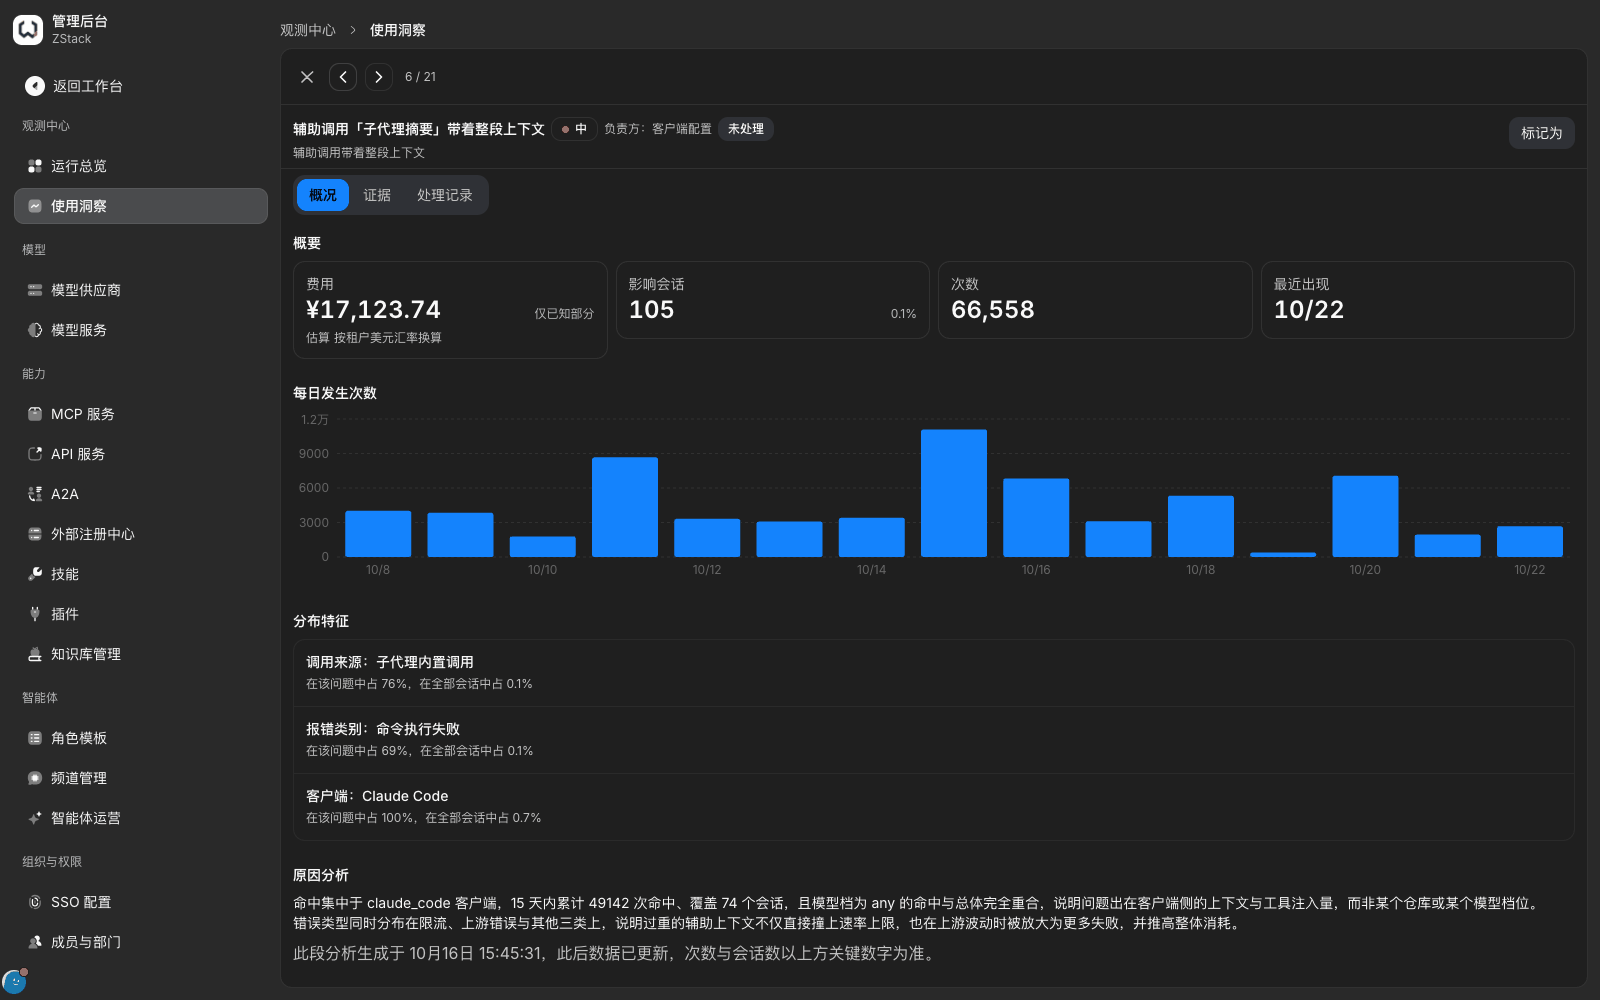
- 打开「管理后台 › 观测中心 › 使用洞察 › 问题」,查找辅助类问题(例如「辅助调用『…』带着整段上下文」),点进详情。
- 在「分布特征」中读「调用来源」维度,它给出「子代理内置调用」这类来源在该问题中、以及在全部会话中的占比。
- 需要逐轮核对时,打开会话详情「概要」页签读「重试 · 切换渠道 · 排队」计数;再导出 JSONL 的「轮次运维明细」,每行一轮,带子代理、辅助调用、上下文压缩三项分道计数与该轮重试次数。
你会看到
- 「用途」筛选的取值是端点用途,与「调用目的」不是同一概念,两者不能混用。
- 平台内部对每次调用记有「调用目的」,取值包括员工对话、子代理、上下文压缩、重试、金丝雀、平台内部调用、控制台试用、影子分派,以及护栏、意图识别、敏感信息识别等判断类调用;金丝雀与平台内部调用不计入租户账。
注意
- 通过外部 API 密钥接入的客户端(例如编程助手),其调用一律按「员工对话」计量,这类客户端自己产生的子代理、压缩、标题生成调用在网关侧无法与主对话区分;需要按用途拆分时,请改由平台托管的智能体发起调用。
17.6 用预算与硬墙控制成本
适用场景:给某个成员、部门或职能组限定周期内的 Token 或金额;或给试用服务、批处理服务设硬上限,防止意外跑量。
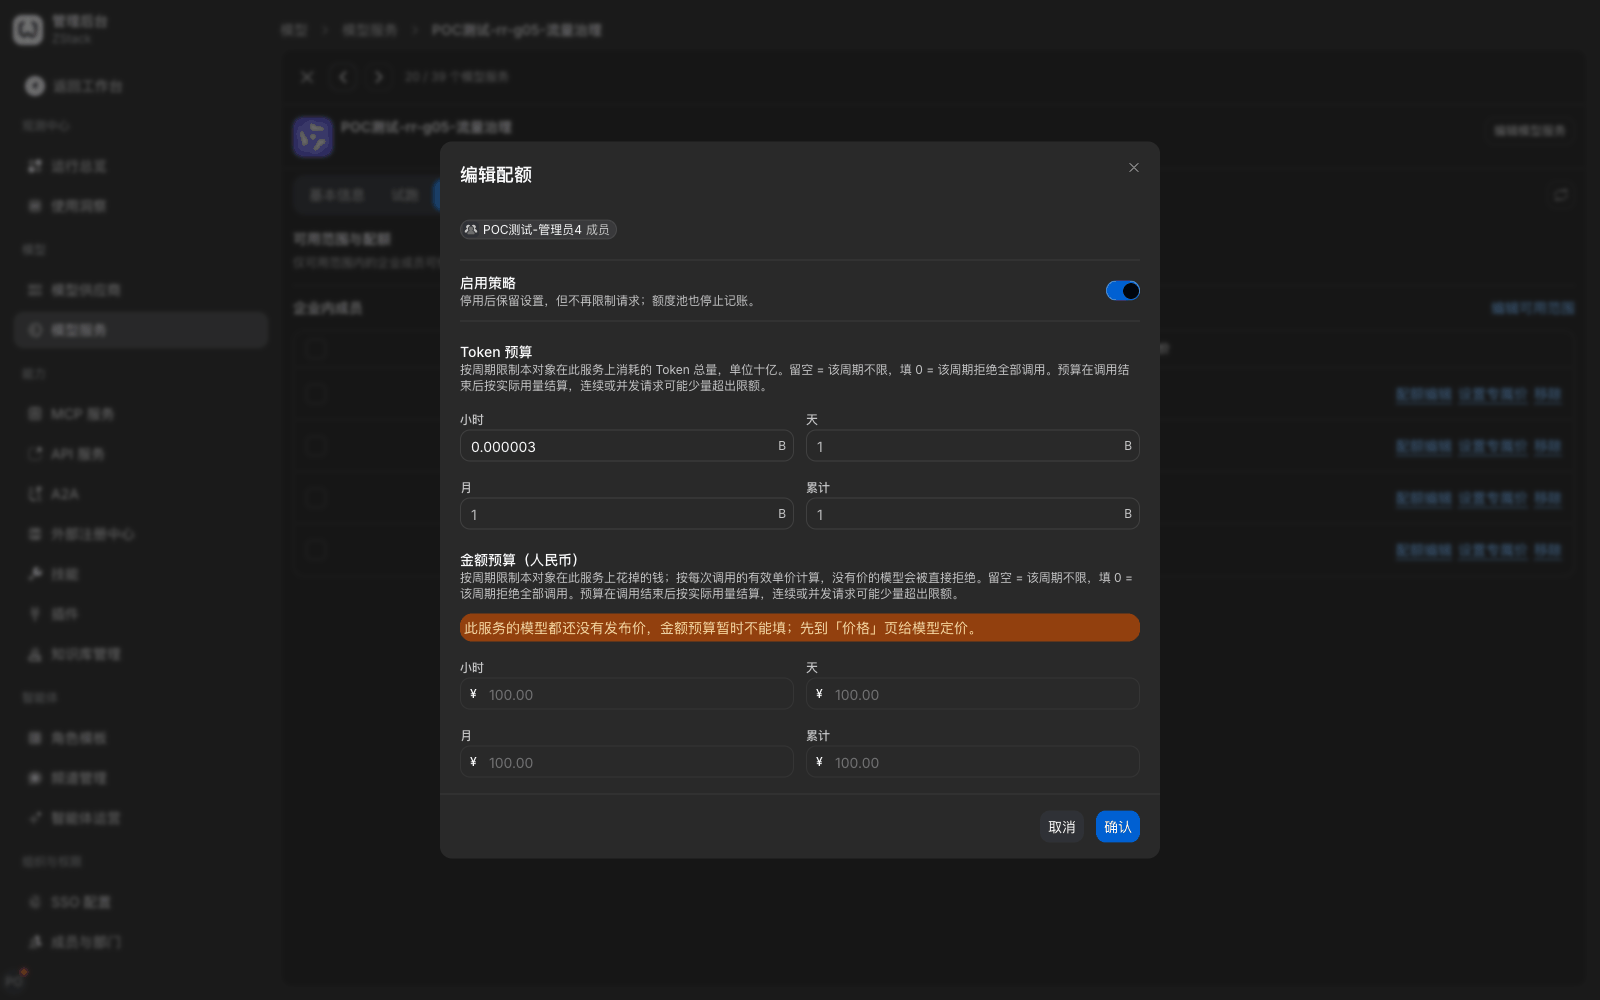
前提:账号为租户管理员,或对该模型分组有管理权限。设置金额预算前分组中模型的上游必须已有发布价;未定价时对话框提示「此分组的上游都还没有发布价,金额预算暂时不能填」,需先到「价格」页定价(第 5 章)。
操作步骤
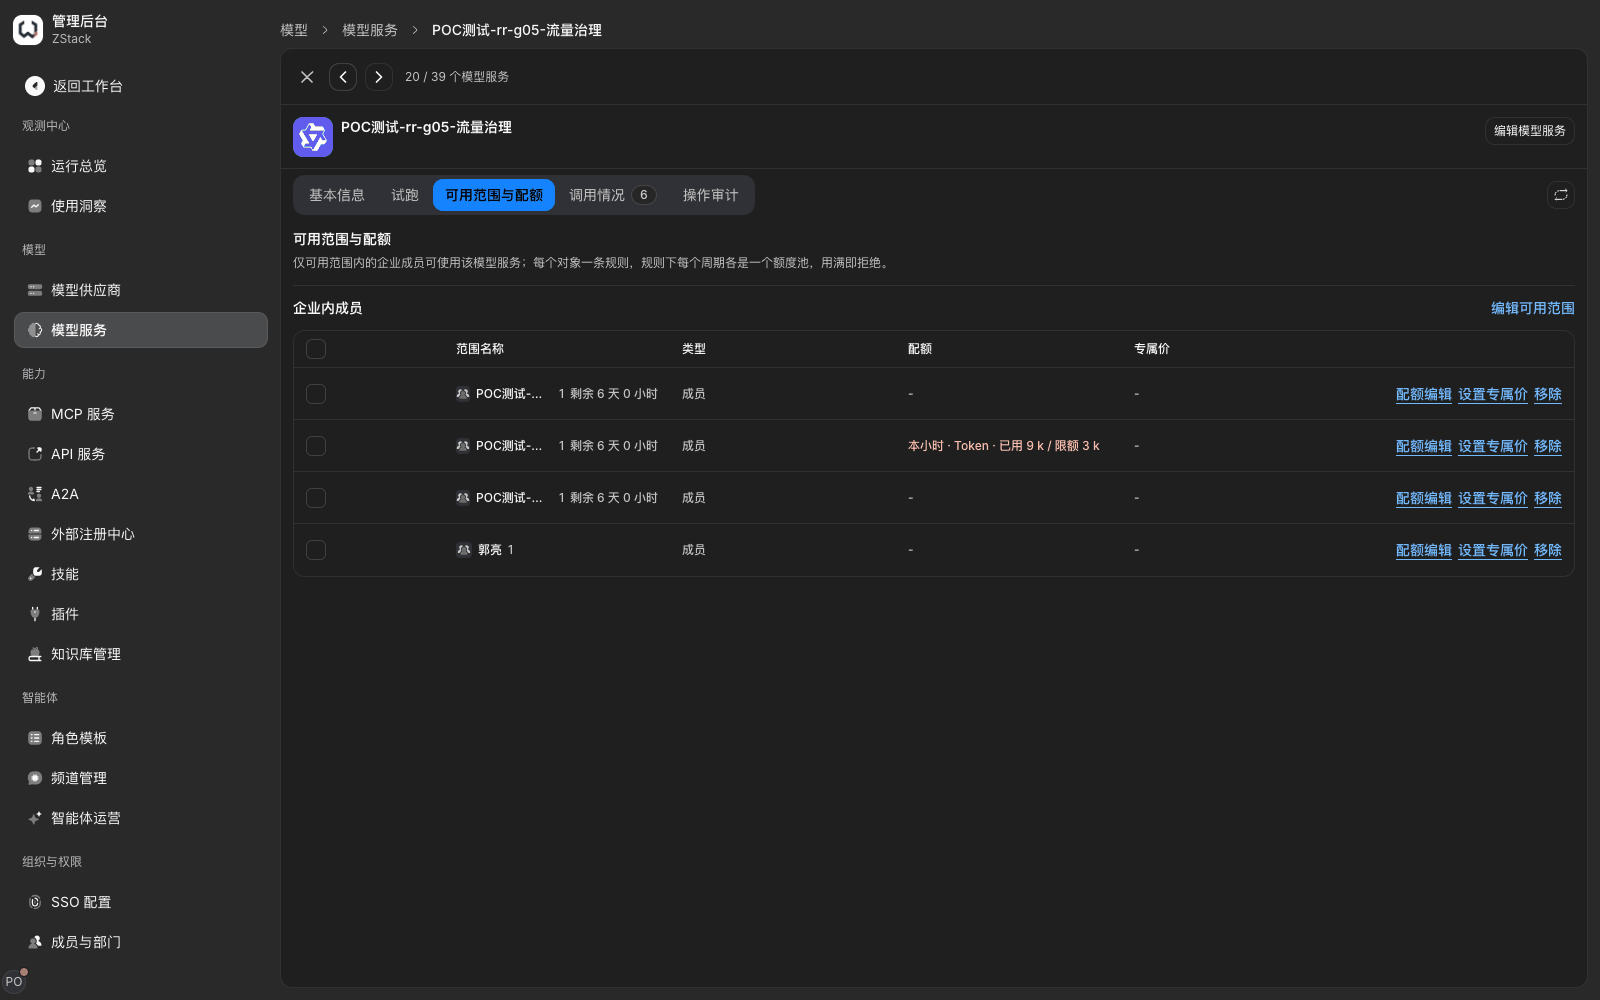
- 进入「管理后台 › 组织与权限 › 模型分组」,打开目标分组,选择「可用范围与配额」页签。
- 在需要限制的对象一行点击「配额编辑」,确认「启用策略」开关为开启。
- 在「Token 预算」中按周期填写上限(单位十亿 B,例如
0.000003表示 3000 Token),在「金额预算(人民币)」中按周期填写金额上限。不需要限制的周期留空,然后点击「确认」。 - 需要限制整个服务(不区分对象)时,在服务详情「基本信息」页签点「编辑配额」,在「服务级配额」中填写后确认。
你会看到
- 保存后对象行按「本小时 / 今日 / 本月 / 累计」四行显示已用与限额,超限时该行标红。
- 超额后调用返回 HTTP 429。错误体中
budget区分触发的是 Token 预算(token)还是金额预算(money),period给出周期,window_end给出窗口结束时间;响应头x-should-retry: false表示不可重试:
{
  "error": {
    "type": "insufficient_quota",
    "code": "insufficient_quota",
    "reason": "POOL_EXHAUSTED",
    "details": [{
      "reason": "pool_exhausted",
      "metadata": { "budget": "money", "period": "hour", "used": "…", "limit": "…", "window_end": "…" }
    }]
  }
}
注意
- 计费口径:额度在调用结束后按实际用量记账,因此单次调用可能把已用量推过限额,从下一次调用起拒绝。超出量至多为一次请求的用量,单次用量很大的场景要给限额留余量。
- 留空与填 0 含义相反:留空是该周期不限,填 0 是该周期一次也不允许。要取消全部周期限制请关闭「启用策略」,而不是把每个周期都清空——只清空周期而开关仍开着时,对话框会提示「启用的策略至少要保留一个周期预算」。关闭「启用策略」后设置仍保留,但不再限制请求,额度池也停止记账。
- 小时、天、月按自然周期滚动,「累计」从启用起一直累加。配额保存后并非瞬时生效,调整后稍等片刻再验证。
- 金额预算只对已定价的模型计量:带金额预算的调用会跳过未定价的模型,可用模型全部未定价时返回 429、原因
POOL_MONEY_UNPRICED;先到「价格」页补齐发布价。配额只管总量,速率与并发限制在流量规则中配置(第 15 章)。
能力说明
| 不提供的能力 | 替代做法 |
|---|---|
| :-- | :-- |
| 按 Token 排序的消耗排行 | 用「筛选 › 模型」逐个收窄后读「总 Token 消耗量」,或导出用量汇总后排序(17.3 节) |
| 按接口类型拆分的排行 | 在「请求」页签按「上游端点」查看,或导出完整调用记录后分组(20.1 节) |
| 按工作空间并列的费用排行 | 逐个切换「数据范围 › 工作空间」读「总消耗费用」,或导出逐条明细后汇总(18.2 节) |
| 无法归属记录的原因说明 | 打开代表性调用,看「概要」中的发起人、接入凭据与客户端字段判断(17.2 节) |
| 外部客户端隐性消耗按调用目的拆分 | 用会话导出的分道计数估算,或改由平台托管智能体发起(17.5 节) |
| 单个对象配额接近阈值的推送 | 在「运行总览」的「预算」面板查看「接近限额」状态(第 18.1 节) |
| 包月套餐与套餐剩余额度 | 由管理员在模型分组中为对象设置周期配额,并对特定对象设置「对象专属价」(17.6 节、18.6 节) |
---